XÂY DỰNG NỂN TẢNG THU THẬP VÀ XỬ LÝ DỮ LIỆU TIẾNG NÓI
MỞ ĐẦU
- Tính cấp thiết của đề tài
Với xu thế phát triển của xã hội ngày nay, việc ứng dụng công nghệ thông tin phục vụ đời sống ngày càng phổ biến. Hiện nay, các hệ thống phần mềm đã có khả năng mô phỏng được giao tiếp giữa người với máy thông qua việc nhận dạng và tổng hợp tiếng nói. Nghiên cứu nhận dạng và tổng hợp tiếng nói đã được các nước trên thế giới thực hiện nhiều năm qua và cũng đã có những thành công nhất định. Ở Việt Nam việc xử lý tiếng Việt cũng có nhiều công trình nghiên cứu và thử nghiệm, tuy nhiên, các kết quả vẫn còn hạn chế, cần có nhiều nghiên cứu nữa trong vấn đề này.
Ngoài ra, đất nước Việt Nam có nhiều vùng miền, mỗi vùng miền lại có một loại giọng nói và âm điệu khác nhau. Đất nước Việt Nam cũng có nhiều dân tộc, khi các dân tộc học tiếng Việt và nói tiếng Việt lại cũng có một cách phát âm và âm điệu khác nhau, dẫn đến có dân tộc khác nhau hoặc các người từ các vùng miền khác nhau khi giao tiếp bằng tiếng Việt với nhau rất khó. Nhưng với sự phát triển của khoa học công nghệ hiện nay thì chúng ta có thể sử dụng phần mềm có thể chuyển đổi/khôi phục/tái tạo âm thanh sao cho phù hợp với người mỗi vùng miền hay dân tộc khác nhau. Điều này lại phát sinh vấn đề về trí tuệ nhân tạo và cần dữ liệu lớn về âm tín hiệu tiếng nói của người đọc tiếng Việt. Mặc dù bộ dữ liệu tiếng nói là thành phần thiết yếu để xây dựng các công cụ xử lý tiếng nói, hiện nay lượng dữ liệu tiếng nói tiếng Việt là khá hạn chế.
Nhằm xây dựng kho dữ liệu lớn phục vụ cho các nghiên cứu về xử lý tiếng nói tiếng Việt, luận văn xây dựng một hệ thống theo mô hình client/server. Trong đó, phía client là app trên điện thoại di động thông minh cho phép thu thập dữ liệu tiếng nói và thông tin người cung cấp dữ liệu đơn giản và thuận tiện. Phía server là hệ thống lưu trữ tập trung, cho phép lưu trữ và quản lý số lượng lớn mẫu ghi âm tiếng nói và một số công cụ thuật toán cho phép hỗ trợ xử lý tiếng nói.
Qua nghiên cứu, luận văn làm rõ cách xử lý sơ bộ tiếng nói, mô hình, phương pháp nào là tương đối tốt cho việc lưu trữ, quản lý dữ liệu tiếng nói tiếng Việt. Bên cạnh đó, luận văn tiến hành xây dựng một chương trình thực tế và thu thập mẫu để chứng minh cho những hiểu biết của tác giả về mô hình lưu trữ quản lý mẫu dữ liệu lớn phục vụ xử lý tiếng nói.
- Mục tiêu, phạm vi nghiên cứu của luận văn
Luận văn nghiên cứu những ý tưởng cơ bản và các phương pháp được sử dụng trong mô hình thu thập, lưu trữ và quản lý dữ liệu tiếng nói lớn từ đó xây dựng một hệ thống phần mềm có khả năng thu thập dữ liệu tiếng nói phân tán, xử lý sơ bộ mẫu và lưu trữ dữ liệu sẵn sàng phục vụ xử lý tiếng nói theo phương pháp dữ liệu lớn. Với các kết quả cụ thể:
– Nghiên cứu, cài đặt và đánh giá hiệu quả thuật toán tính tỉ lệ tín hiệu trên nhiễu (SNR) của tín hiệu tiếng nói trên miền thời gian dùng để gán nhãn các tín hiệu tiếng nói thu thập được.
– Xây dựng hệ thống phần mềm nhằm thu thập CSDL tiếng nói phục vụ cho các nghiên cứu về xử lý tiếng nói như nhận dạng hay tổng hợp tiếng nói, với các tính năng:
+ Tiền xử lý dữ liệu thu thập được để đánh giá chất lượng ghi âm.
+ Cho phép người dùng nghe lại và đánh giá chất lượng các đoạn thu âm nhằm làm sạch dữ liệu thu thập được, ví dụ như phát hiện tín hiệu ghi âm không trùng khớp với nội dung kịch bản thu âm.
+ Phát triển hệ thống theo mô hình client-server và ứng dụng di động đa nền tảng.
Đối tượng nghiên cứu bao gồm: Các đặc tính cơ bản của Tiếng Việt; Tính vùng miền của Tiếng Việt; Các thuật toán tính tỉ lệ tín hiệu trên nhiễu của tín hiệu tiếng nói; Mô hình lưu trữ dữ liệu lớn; Lập trình ứng dụng di động; Các hệ thống thư viện lập trình hỗ trợ xử lý tiếng nói;
Phạm vi nghiên cứu bao gồm: Trong thời gian hạn chế và mức độ phức tạp của bài toán xử lý tiếng nói với dữ liệu lớn, luận văn này tập trung xây dựng nền tảng thu thập dữ liệu lớn phục vụ cho các nghiên cứu tiếp theo trong lĩnh vực tổng hợp và nhận dạng tiếng nói của người Việt.
- Phương pháp và nội dung nghiên cứu
Luận văn sử dụng phương pháp nghiên cứu kết hợp giữa nghiên cứu lý thuyết với phương pháp thực nghiệm thông qua xây dựng cơ sở dữ liệu và phát triển phần mềm xử lý. Hướng tiếp cận chính là nghiên cứu tài liệu qua các bài báo đăng trên các tạp chí khoa học và khai thác các hệ thống phần mềm liên quan đến vấn đề đang nghiên cứu trên mạng Internet.
* Ý nghĩa khoa học
– Tổng hợp các kiến thức liên quan đến xử lý và lưu trữ tín hiệu tiếng nói tiếng Việt.
– Nắm vững và vận dụng ngôn ngữ lập trình thiết bị di động, dịch vụ web và hệ quản trị CSDL để xây dựng ứng dụng.
– Kết quả của luận văn là một cơ sở dữ liệu tiếng nói lớn đã được gán nhãn với độ chính xác cao sẵn sàng phục vụ các hệ thống xử lý tiếng nói trong tương lai.

* Ý nghĩa thực tế
– Xây dựng ứng dụng theo mô hình client/server để thu thập CSDL tiếng nói lớn phục vụ cho các nghiên cứu về xử lý tiếng nói.
Cấu trúc luận văn gồm: phần mở đầu, 3 chương nội dung, kết luận, danh mục tài liệu tham khảo và phụ lục.
Chương 1: Tổng quan về xử lý tiếng nói.
Chương 2: Các thuật toán tính tỉ lệ tín hiệu trên tạp âm của tín hiệu tiếng nói.
Chương 3. Triển khai và kết quả thực nghiệm
- Kết quả đạt được của luận văn
Kết quả của luận văn bao gồm:
- Báo cáo tổng thể về cơ sở lý thuyết xử lý tiếng nói, phương pháp thu thập và xử lý dữ liệu tiếng nói với số lượng lớn.
- Đề xuất sử dụng thuật toán và xây dựng hệ thống hỗ trợ xử lý tiếng nói, lưu trữ và cung cấp dịch vụ phù hợp để làm nền tảng cho các ứng dụng xử lý tiếng nói tiếng Việt.
- Một số dữ liệu CSDL tiếng nói được thu thập, xử lý sơ bộ và gán nhãn nhằm chứng minh cho tính hiệu quả và khả thi của hệ thống.
CHƯƠNG 1
TỔNG QUAN VỀ XỬ LÝ TIẾNG NÓI
1.1. Tổng quan về tổng hợp tiếng nói
Tổng hợp tiếng nói là một bộ môn khoa học nhằm nghiên cứu và xây dựng các công nghệ để tạo ra âm thanh tiếng nói từ máy giống như tiếng nói của con người.
Trong những năm gần đây tiếng nói tổng hợp đã trải qua chặng đường khá dài, việc ứng dụng tổng hợp tiếng nói vào thực tiễn đã trở nên phổ biến. Tuy nhiên, chất lượng âm thanh và độ tự nhiên của tiếng nói tổng hợp cho đến nay vẫn còn là những vấn đề mở.
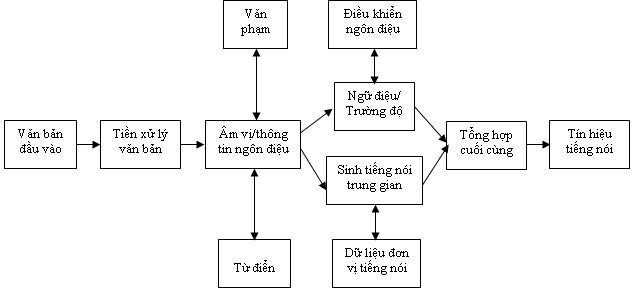
Hình 1.1 – Hệ thống TTS tổng quát.
Tương tự ứng dụng tổng hợp tiếng nối, ứng dụng nhận dạng tiếng nói rất phổ biến trong thời gian gần đây, cho phép giao tiếp giữa người và máy. Từ các tín hiệu âm thanh người nói, thông qua bộ phận ghi âm và hệ thống nhận dạng, máy tính sẽ hiểu và phân biệt được các ý nghĩa của câu nói.
1.2. Khái niệm về tín hiệu tiếng nói
Về bản chất, âm thanh từ lời nói, âm thanh trong thế giới tự nhiên đều là những sóng âm lan truyền trong môi trường. Khi chúng ta nói dây thanh trong hầu bị chấn động, tạo nên những sóng âm, sóng truyền trong không khí đến màng nhĩ – một màng mỏng rất nhạy cảm của tai ta – làm cho màng nhĩ cũng dao động, các dây thần kinh của màng nhĩ sẽ nhận được cảm giác âm khi tần số dao động của sóng đạt đến một độ lớn nhất định.
1.2.1. Biểu diễn trên miền thời gian
Âm thanh dưới dạng sóng được lưu trữ theo định dạng thông dụng trong máy tính là file .wav với các tần số lấy mẫu thường gặp là: 8000 Hz, 10000 Hz, 11025 Hz, 16000 Hz, 22050 Hz, 32000 Hz, 44100 Hz, …; độ phân giải hay còn gọi là số bít/mẫu là 8 hoặc 16 bít và số kênh là 1 (Mono) hoặc 2 (Stereo).
Tuỳ theo thiết bị, thời điểm, người phát âm thì dữ liệu âm thanh được số hoá, biểu diễn lại trong máy tính sẽ khác nhau.
1.2.2. Biểu diễn trên miền tần số
Một trong những đại lượng đặc trưng để biểu diễn tín hiệu tiếng nói trên miền tần số đó là phổ.
Phổ trong tín hiệu tiếng nói là biểu diễn của sự phụ thuộc của biên độ vào thời gian và tần số, là hình ảnh biểu diễn của tín hiệu tiếng nói theo trục của tần số.
1.3. Các đặc tính cơ bản của tín hiệu tiếng nói
Tiếng nói được tạo ra từ độ rung của dây thanh âm trong thanh quản thông qua khí quản và hoạt động của tuyến âm. Như vậy, tiếng nói chính là âm thanh. Tiếng nói có chu kỳ dao động, có tần số âm thanh.
1.3.1. Âm sắc
Âm sắc là một trong bốn đặc tính cơ bản của âm thanh cũng như tín hiệu tiếng nói. Âm sắc giúp ta phân biệt được tiếng nói của từng âm và của mỗi người được cảm nhận khác nhau như thế nào. Âm sắc liên quan mật thiết đến phổ của tín hiệu.
1.3.2. Cường độ
Cường độ là độ to hay nhỏ của âm thanh nói ra. Cường độ càng lớn thì âm thanh truyền càng xa trong môi trường truyền. Cường độ âm là số năng lượng mà sóng âm truyền đi trong một thời gian nhất định trên đơn vị diện tích cố định và vuông góc với phương truyền âm.
1.3.3. Trường độ
Trường độ hay còn được biết là độ dài của âm phát ra phụ thuộc vào sự chấn động lâu hay nhanh của phần tử môi trường truyền đi. Trường độ của mỗi người khác nhau và mỗi thời điểm cũng khác nhau.
Âm hữu thanh (voiced speech) là âm phát ra có thanh, ví dụ như các nguyên âm /a/, /e/, /i/, /o/, /u/ hoặc các phụ âm như /m/, /n/, /l/. Thực ra âm hữu thanh được tạo ra là do việc không khí qua thanh môn (thanh môn tạo ra sự khép mở của dây thanh dưới sự điều khiển của hai sụn chóp) với một độ căng của dây thanh sao cho chúng tạo nên dao động.
Âm vô thanh (voiced speech) là âm khi tạo ra tiếng thì dây thanh không rung hoặc rung đôi chút tạo ra giọng như giọng thở, ví dụ như /t/, /p/ hay /k/.
Trong xử lý tín hiệu tiếng nói, âm vô thanh không có ích khi tính tần số cơ bản. Vì âm vô thanh không có khung tín hiệu tuần hoàn. Tần số cơ bản ở âm vô thanh là không xác định.
1.4. Xử lý ngắn hạn (short-time processing)
Tín hiệu tiếng nói có một tính chất quan trọng là các đặc tính của nó thay đổi tương đối chậm theo thời gian. Thông thường, các đặc tính của tín hiệu ổn định trong khoảng thời gian từ 10 ms đến 30 ms. Do đó, người ta thường chia tín hiệu cần xử lý thành các khung tín hiệu liên tiếp nhau, mỗi khung có độ dài từ 10 ms đến 30 ms. Sau đó, ta tiến hành xử lý trên mỗi khung tín hiệu này. Các khung tín hiệu này được gọi là các khung phân tích, các khung này có thể trùng nhau (overlap) một phần để đảm bảo các đặc tính của tín hiệu biến đổi trơn tru giữa 2 khung liên tiếp. Việc chia khung này sẽ được lặp lại từ đầu đến cuối trên tín hiệu cần xử lý.
1.5. Tỉ lệ tín hiệu trên nhiễu của tín hiệu tiếng nói (SNR)
SNR (Signal-to-noise ratio) là một thuật ngữ dùng để tính tỉ lệ giữa giá trị năng lượng của một tín hiệu và năng lượng nhiễu ảnh hướng đến độ chính xác của thông tin. SNR phục vụ trong việc gắn nhãn các tín hiệu tiếng nói thu thập được, nhằm đánh giá chất lượng các cuộc ghi âm. Có nhiều thuật toán tính SNR trong khuôn khổ luận văn xin giới thiệu và thực nghiệm hai thuật toán như sau:
1.5.2. Các lý do cần tính toán SNR của tín hiệu âm thanh
Việc tính toán thông số SNR của một nguồn âm thanh rất quan trọng trong thu thập dữ liệu tiếng nói phục vụ việc tổng hợp cũng như nhận dạng giọng nói bằng phương pháp học máy. Có một số nguyên nhân chính là:
Một là, tín hiệu tiếng nói về bản chất là tín hiệu ngẫu nhiên, không theo quy luật nhất định, dẫn đến việc tìm quy luật về tính tuần hoàn của tín hiệu tiếng nói không dễ dàng.
Hai là, trong môi trường thu âm thực tế, không chỉ có tiếng nói mà còn các nguồn âm khác được phát ra.
Ba là, trong các ứng dụng nhận dạng giọng nói thường được sử dụng thực tế tại đời sống khi các hoạt động của người sử dụng đang diễn ra nên việc xuất hiện nguồn nhiễu là không tránh khỏi.
1.5.3. Các thuật toán tính SNR
a) Thuật toán Voiced/Unvoiced/Silence (VUS)
Để tính được SNR, cần phải xác định đoạn im lặng trong đoạn ghi âm. Để xác định đoạn im lặng, chúng tôi sử dụng thuật toán VUS, xác định các đoạn hữu thanh/ vô thanh/ khoảng lặng (voiced/ unvoiced/ silence) dựa trên năng lượng thời gian ngắn (STE), tỷ lệ trượt ngang (ZCR) và tỷ lệ năng lượng băng tần thấp/ toàn dải (LF).
b) Thuật toán Waveform Amplitude Distribution Analysis (WADA)
Với thuật toán này, biên độ giọng nói gốc tuân theo luật phân phối Gamma với tham số hình dạng bằng 0.4 và biên độ nhiễu tuân theo luật phân phối Gaussian. So với thuật toán NIST STNR, thuật toán WADA-SNR cho ra kết quả ít sai khác khi tính toán với các loại nhiễu khác nhau (tiếng ồn trắng, nhạc nền, giọng nói nhiễu khác). Hơn nữa, thuật toán này cũng khá hiệu quả về mặt tính toán.
CHƯƠNG 2
CÁC THUẬT TOÁN TÍNH TỈ LỆ TÍN HIỆU TRÊN TẠP ÂM CỦA TÍN HIỆU TIẾNG NÓI
Mở đầu
Như đã đề cập trong chương trước, tham số SNR của tín hiệu tiếng nói là tham số có ý nghĩa quan trọng trong lĩnh vực xử lý tiếng nói. Tìm được SNR chính xác là tiền đề để tiến hành các nghiên cứu khác trong lĩnh vực này.
Thuật toán VUS (Voiced/Unvoiced/Silence)
Để tính được SNR, cần phải xác định đoạn im lặng trong đoạn ghi âm. Để xác định đoạn im lặng, chúng tôi sử dụng thuật toán VUS, xác định các đoạn hữu thanh/ vô thanh/ khoảng lặng (voiced/ unvoiced/ silence) dựa trên năng lượng thời gian ngắn (STE), tỷ lệ trượt ngang (ZCR) và tỷ lệ năng lượng băng tần thấp/ toàn dải (LF).
Tín hiệu đầu vào cần phân biệt đoạn lời nói và khoảng lặng, và sau đó, đoạn lời nói cần phân biệt thành phần hữu thanh và thành phần vô thanh. Phân biệt đoạn lời nói và khoảng lặng chỉ dựa trên năng lượng ngắn hạn. Ngưỡng được đặt theo phương pháp gốc. Phân biệt đoạn không lời nói và khoảng lặng là dựa trên ngưỡng. Các thuộc tính phân biệt thành phần hữu thanh và thành phần vô thanh là năng lượng thời gian ngắn, tỷ lệ truyền qua không và tỷ lệ năng lượng băng tần thấp/ toàn dải. Các thuộc tính này được chuẩn hóa và được cân nhắc theo phương pháp của Kondoz.
Thuật toán WADA (Waveform Amplitude Distribution Analysis)
Thuật toán WADA-SNR là một thuật toán tương đối mới được sử dụng để ước tính tỉ số SNR của tín hiệu giọng nói dựa trên phép phân tích luật phân phối biên độ của tín hiệu. Với thuật toán này, biên độ giọng nói gốc tuân theo luật phân phối Gamma với tham số hình dạng bằng 0.4, và biên độ nhiễu tuân theo luật phân phối Gaussian.
Đặc tính của giọng nói gốc và tiếng ồn
Hàm mật độ xác suất của một giọng nói được biểu diễn bởi phương trình sau:
| (1) |
Trong đó:
- x: biên độ của giọng nói
- αx: tham số hình dạng của phân phối gamma. αx = 0.4 đã được chứng minh là giá trị phù hợp nhất để mô phỏng tín hiệu giọng nói nên giá trị này sẽ lấy mặc định là 0.4 trong các tính toán
- βx: tham số tỷ lệ của phân phối gamma. Giá trị này phục vụ cho việc chuẩn hóa hàm mật độ xác suất và không có ảnh hưởng gì đến phép ước tính SNR nên sẽ được lấy bất kỳ.
Tiếng ồn được giả định tuân theo luật phân phối Gaussian v[n] và có hàm mật độ xác suất như sau:
| (2) |
Trong đó:
- σv: độ lệch chuẩn của tiếng ồn
Giả sử rằng cả giọng nói và tiếng ồn đều có giá trị trung bình bằng 0 và độc lập thống kê với nhau. Giọng nói có nhiễu z[n] sẽ được tính theo công thức sau:
| z[n] = x[n] + v[n] | (3) |
Từ (1), (2), (3) năng lượng của giọng nói và tiếng ồn được tính toán như sau:
| (4) | |
Trong đó:
- Px: năng lượng của giọng nói gốc
- Pv: năng lượng của tiếng ồn
Cuối cùng, ta có tỷ số SNR của giọng nói có nhiễu z[n]:
2.5. Kết quả so sánh giữa 2 thuật toán
F:\DỮ LIỆU COP CỦA CHỊ YẾN\DAI HOC DA NANG\KHOA HOC MAY TINH\LE TUNG DUONG\TOM TAT
XÂY DỰNG NỂN TẢNG THU THẬP VÀ XỬ LÝ DỮ LIỆU TIẾNG NÓI XÂY DỰNG NỂN TẢNG THU THẬP VÀ XỬ LÝ DỮ LIỆU TIẾNG NÓI