
Tối ưu hóa truy vấn cơ sở dữ liệu phân tán
Ngày nay cùng với sự phát triển nhanh chóng của công nghệ thông tin, có thể công nhận rằng công nghệ thông tin (CNTT) đã thâm nhập vào mọi hoạt động kinh tế xã hội và trở thành một ngành kinh tế mũi nhọn[1]. CNTT chính là “chìa khóa” của sự thay đổi, là đòn bẩy giúp Việt Nam phát triển trên nhiều lĩnh vực[2]. Bên cạnh đó thông tin là nguồn tài nguyên quý giá của một tổ chức, số lượng ấn phẩm thông tin gia tăng theo cấp số nhân, nguồn dữ liệu khổng lồ phát sinh liên tục mô hình dữ liệu tối ưu, giúp cho việc tổng hợp tìm kiếm thông tin một cách nhanh chóng đầy đủ và chính xác.
Việc quản lý các tổ chức, doanh nghiệp, trường học đòi hỏi tính chính xác, liên tục, tối ưu và đồng bộ giữa các bộ phận, nhiều cơ sở khác nhau, Các cơ sở dữ liệu (CSDL) của một tổ chức không chỉ tập trung tại một chi nhánh duy nhất mà được phân tán ở nhiều chi nhánh khác. Việc quản lý CSDL theo kiểu truyền thống, hay CSDL tập trung như trước đây sẽ không giải quyết được vấn đề nêu trên. Xuất phát từ những nhu cầu thực tế trên tôi chọn nghiên cứu đề tài “Tối ưu hóa truy vấn cơ sở dữ liệu phân tán” làm đề tài luận văn tốt nghiệp thạc sỹ và xây dựng ứng dụng quản lý trong trường Cao đẳng Kiên Giang nhằm thay thế các công cụ quản lý CSDL theo kiểu tập trung trước đây.
- Ngoài phần mở đầu và kết luận, luận văn được cấu trúc như sau:
- Chương 1: Giới thiệu khái quát về cơ sở dữ liệu phân tán.
- Chương 2: Tối ưu CSDLPT. Trình bày các thuật toán tối ưu hóa câu truy vấn CSDLPT: INGRES phân tán, SYSTEM R*.
- Chương 3: Cài đặt thử nghiệm thuật toán INGRES thực hiện tối ưu hóa chương trình quản lý đào tạo của trường Cao đẳng Kiên Giang.
CHƯƠNG 1: CƠ SỞ DỮ LIỆU PHÂN TÁN
1.1 Khái niệm về hệ cơ sở dữ liệu phân tán (CSDLPT)
1.1.1 Khái niệm
Cơ sở dữ liệu phân tán là một tập hợp các dữ liệu phục thuộc lôgic lẫn nhau của cùng một hệ thống và được lưu trữ trên các trạm của một mạng máy tính. Cơ sở dữ liệu phân tán làm tăng khả năng truy nhập tới cơ sở dữ liệu lớn trên mạng. Trong hệ thống đó mỗi máy tính quản lý một cơ sở dữ liệu thành phần được gọi là 1 node hoặc site[4].
Định nghĩa này nhấn mạnh hai khía cạnh quan trọng của cơ sở dữ liệu phân tán
- Tính phân tán: Thực tế dữ liệu không cư trú ở cùng một trạm, vì vậy chúng ta có thể phân dữ liệu phân tán với cơ sở dữ liệu tập trung.
- Sự tương quan logic: Các dữ liệu có một số tính chất ràng buộc lẫn nhau và như vậy có thể phân biệt cơ sở dữ liệu phân tán với tập các cơ sở dữ liệu địa phương hoặc với các tệp ở các trạm khác nhau trên mạng.
1.1.2 Các thành phần của hệ quản trị cơ sở dữ liệu phân tán(DDBMS)
- Tính phân tán: Thực tế dữ liệu không cư trú ở cùng một trạm, vì vậy chúng ta có thể phân biệt một cơ sở dữ liệu phân tán với cơ sở dữ liệu tập trung.
- Sự tương quan logic: Các dữ liệu có một số tính chất ràng buộc lẫn nhau và như vậy có thể phân biệt cơ sở dữ liệu phân tán với tập các cơ sở dữ liệu địa phương hoặc với các tệp ở các trạm khác nhau trên mạng.
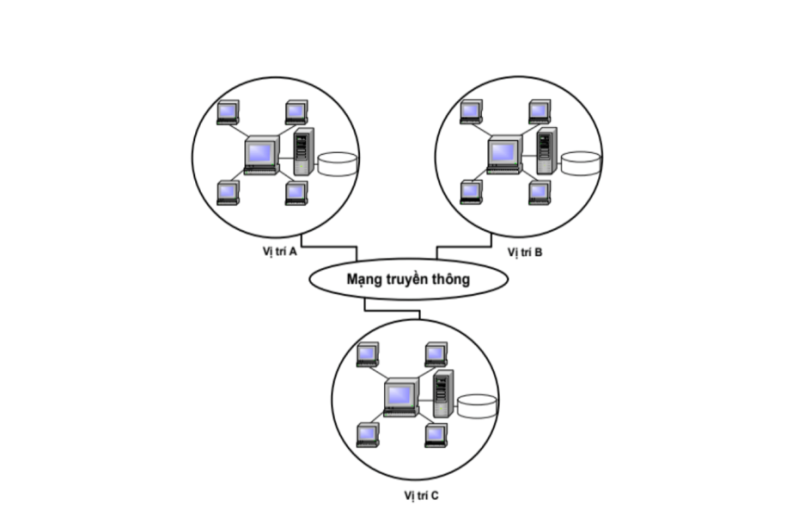
Hình 1.1: Mô hình hệ Cơ sở dữ liệu phân tán.
Các thành phần của hệ quản trị cơ sở dữ liệu phân tán
(DDBMS) có chức năng hỗ trợ việc tạo và bảo trì cơ sở dữ liệu phân tán, chúng có các thành phần tương tự như một hệ quản trị cơ sở dữ liệu tập trung thành các thành phần hỗ trợ trong việc chuyển tải dữ liệu đến các trạm và ngược lại.
Các thành phần sau đây của một DDBMS thương mại phải có:
- Quản trị dữ liệu (Database managemnet): DB
- Truyền thông dữ liệu (Data Communication): DC
- Từ điển dữ liệu(Data Dictionary): DD dùng để mô tả thông tin về sự phân tán của dữ liệu mạng.
- Cơ sở dữ liệu phân tán(Distributed Database): DDB
1.1.3 Những ưu điểm của hệ cơ sở dữ liệu phân tán
- Cho phép quản lý dữ liệu với nhiều mức trong suốt
- Tăng độ tin cậy và khả năng sẵn sàng
- Cải thiện hiệu năng
- Dễ dàng mở rộng
1.1.4 Những nhược điểm của hệ cơ sở dữ liệu phân tán
– Độ phức tạp thiết kế và cài đặt hệ thống tăng: Hệ quản trị cơ sở dữ liệu phân tán phải bổ sung thêm các chức năng như:
- Theo dõi dấu vết dữ liệu
- Xử lý các truy vấn phân tán
- Quản lý giao dịch phân tán
- Phục hồi cơ sở dữ liệu phân tán
- Quản lý các bản sao
- Quản lý thư mục – catalog phân tán
– Khó điều khiển tính nhất quán về dữ liệu
– Các phần mềm hệ thống đảm bảo quản trị, duy trì kết nối, trao đổi dữ liệu trên mạng.
– Bảo mật khó khăn.
1.2. Các đặc trưng trong suốt của cơ sở dữ liệu phân tán
1.2.1. Trong suốt phân tán
- Trong suốt địa điểm
- Trong suốt tên
- Trong suốt bản sao
- Trong suốt phân đoạn
1.2.2. Trong suốt giao dịch
1.2.3. Trong suốt thất bại
1.2.4. Trong suốt thao tác
1.2.5. Trong suốt về tính không thuần nhất
1.3. Kiến trúc tham chiếu của cơ sở dữ liệu phân tán
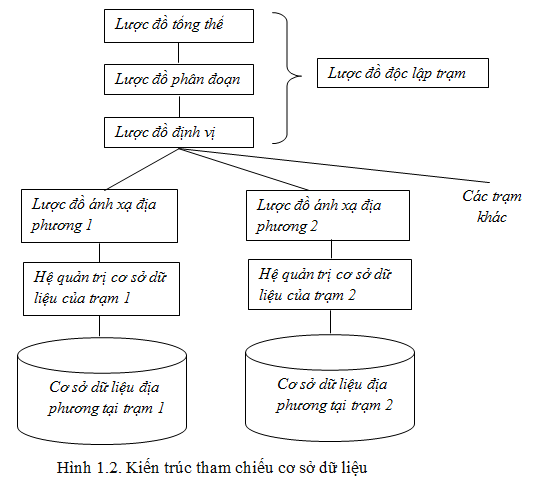
Kiến trúc tham chiếu của cơ sở dữ liệu phân tán
- Lược đồ tổng thể: Mô tả tổng thể và thống nhất chung nhất của tất cả dữ liệu của cơ sở dữ liệu phân tán độc lập với môi trường phân tán.
- Phân đoạn: Mối quan hệ tổng thể có thể được chia thành vài phần không giao nhau được gọi là các đoạn. Lược đồ phân đoạn định nghĩa ánh xạ giữa các quan hệ tổng thể và các phân đoạn. Ánh xạ này là một – nhiều: Một số
- đoạn tương ứng với một quan hệ tổng thể, nhưng chỉ một quan hệ tổng thể tương ứng với một đoạn. Ký hiệu Ri là đoạn thứ i của quan hệ tổng thể R.
- Lược đồ định vị: Định nghĩa ánh xạ từ các phân đoạn vào những trạm chứa những phân đoạn đó. Tất cả các đoạn tương ứng với cùng quan hệ tổng thể R và được đặt tại cùng trạm j tạo thành hình ảnh vật lý của quan hệ tổng thể R tại trạm j.
- Lược đồ ánh xạ địa phương: Ánh xạ các hình ảnh vật lý tới các đối tượng được thao tác bởi các hệ quản trị cơ sở dữ liệu địa phương. Trong hệ không thuần nhất ta có các kiểu ánh xạ địa phương khác nhau tại các trạm khác nhau
1.4 Các kỹ thuật xây dựng cơ sở dữ liệu phân tán
Có 3 chiến lược phân tán dữ liệu cơ bản: sao lặp dữ liệu, phân mảnh dữ liệu và phương pháp hỗn hợp.
1.4.1 Phân mảnh dữ liệu
1.4.1.1 Phân mảnh ngang
1.4.1.2 Phân mảnh ngang dẫn tiếp
1.4.1.3 Phân mảnh dọc
1.4.1.4 Phân mảnh hỗn hợp
1.4.2 Nhân bản dữ liệu
1.5 Tổng kết chương 1
Cơ sở dữ liệu phân tán rất quan trọng vì nhiều lý do khác nhau, nó có thể được cài đặt trên các mạng máy tính diện rộng và các mạng cục bộ. Có hai lý do về tổ chức và kỹ thuật đối với sự phát triển cơ sở dữ liệu phân tán đó là: Cơ sở dữ liệu phân tán được xây dựng để khắc phục các thiếu sót của cơ sở dữ liệu tập trung và nó phù hợp hơn trong cấu trúc phân quyền của nhiều tổ chức. Kỹ thuật cơ sở dữ liệu phân tán được mở rộng và phát triển từ kỹ thuật của cơ sở dữ liệu truyền thống. Trong môi trường mới này, một số vấn đề kỹ thuật đòi hỏi các giải pháp khác, và một số giải pháp hoàn toàn mới.
Tính trong suốt phân tán cung cấp sự độc lập của các chương trình khỏi sự phân tán của cơ sở dữ liệu. Các mức trong suốt phân tán khác nhau có thể được cung cấp bởi một hệ quản trị cơ sở dữ liệu phân tán; Tại mỗi mức, tính trong suốt làm cho người lập trình ứng dụng không biết được sự phân tán dữ liệu.
CHƯƠNG 2: TỐI ƯU HÓA CÂU TRUY VẤN TRONG CƠ SỞ DỮ LIỆU PHÂN TÁN
2.1. Giới thiệu về xử lý truy vấn
Tương lai của các hệ thống cơ sở dữ liệu lớn nằm trong lĩnh vực tính toán phân tán. Lý do chính cho việc này là máy tính phân tán có thể được xây dựng ở mức chi phí thấp mà không cần bất kỳ công nghệ chuyên ngành nào, sử dụng máy tính tuần tự hiện có và mạng máy tính tương đối rẻ. Cơ sở dữ liệu (CSDL) được phân phối trên thực tế trên các vị trí khác nhau bằng cách phân mảnh và sao chép dữ liệu. Phân mảnh chia nhỏ từng quan hệ thành phân mảnh ngang bằng cách sử dụng phép toán chọn Select hoặc phân mảnh dọc sử dụng phép toán chiếu Project. Phân mảnh là cần thiết bởi vì nó cho phép sắp xếp dữ liệu ở gần gần với vị trí sử dụng của nó. Mỗi mảnh cũng có thể được sao chép vào một số vị trí.
2.1.1. Xử lý truy vấn và tối ưu hóa
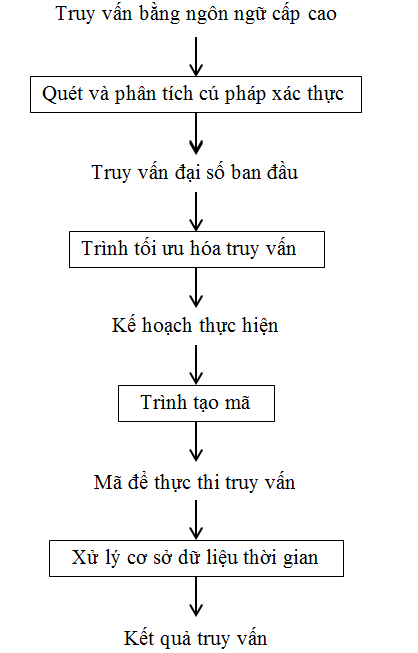
Xử lý truy vấn là quá trình dịch một truy vấn thể hiện bằng một ngôn ngữ cấp cao như SQL sang thao tác dữ liệu cấp thấp. Truy vấn tối ưu hóa đề cập đến quá trình tốt nhất của chiến lược thực hiện một truy vấn đã cho được tìm thấy từ một tập hợp lựa chọn thay thế.
Thông thường xử lý truy vấn liên quan đến nhiều bước[16]. Bước đầu tiên là phân tích truy vấn, trong đó SQL truy vấn đầu tiên được duyệt, phân tích cú pháp và xác thực. Xác định mã thông báo ngôn ngữ – chẳng hạn như từ khóa SQL, tên thuộc tính và tên quan hệ trong câu truy vấn, trong khi trình phân tích cú pháp kiểm tra truy vấn cú pháp để xác định xem nó được xây dựng theo với các quy tắc cú pháp của ngôn ngữ truy vấn. Truy vấn cũng phải được xác thực, bằng cách kiểm tra xem tất cả thuộc tính và tên quan hệ hợp lệ và ngữ nghĩa các tên có ý nghĩa trong lược đồ của cơ sở dữ liệu được truy vấn. Một biểu diễn bên trong của truy vấn sau đó được tạo ra. Truy vấn được thể hiện bằng đại số quan hệ thường được gọi là truy vấn đại số ban đầu và có thể được biểu diễn dưới. Nó thể hiện quan hệ đầu vào của truy vấn dưới dạng các nút lá của cây và thể hiện các phép toán đại số quan hệ như các nút bên trong. Đối với một truy vấn SQL đã cho, có nhiều hơn một truy vấn đại số có thể. Một số các truy vấn đại số tốt hơn các truy vấn khá. Do đó, bước thứ tiếp theo là tối ưu hóa biến đổi truy vấn đại số ban đầu bằng cách sử dụng các phép biến đổi đại số quan hệ thành các truy vấn đại số tối ưu hơn cho đến khi truy vấn tốt nhất được tìm thấy. Một kế hoạch thực hiện truy vấn truy vấn (QEP) sau đó được thành lập được biểu diễn dưới dạng cây truy vấn bao gồm thông tin về phương thức truy cập có sẵn cho mỗi mối quan hệ cũng như các thuật toán được sử dụng để tính toán quan hệ hoạt động trong cây. Bước tiếp theo là tạo mã cho lựa chọn QEP; mã này sau đó được thực hiện trong một trong hai biên dịch hoặc chế độ diễn giải để tạo kết quả truy vấn [3,7].
2.1.2 Mục đích của xử lý truy vấn
- Giảm chi phí truyền thông: Tăng ứng dụng cục bộ làm giảm chi phí truyền thông.
- Nâng cao hiệu suất: Có cơ chế xử lý song song và phân mảnh dữ liệu theo ứng dụng làm cực đại hóa tính cục bộ của ứng dụng.
- Tăng độ tin cậy và tính sẵn sàng: Nếu có một thành phần nào đó của hệ thống bị hỏng, hệ thống vẫn có thể duy trì hoạt động.
- Sử dụng ít tài nguyên.
2.1.3 Chức năng của xử lý truy vấn [2]
- Biến đổi một truy vấn phức tạp thành một truy vấn tương đương đơn giản hơn.
- Phép biến đổi này phải đạt được cả về tính đúng đắn và hiệu quả
- Mỗi cách biến đổi dẫn đến việc sử dụng tài nguyên máy tính khác nhau, nên vấn đề đặt ra là lựa chọn phương án nào dùng tài nguyên ít nhất.
2.1.4 Các phương pháp xử lý truy vấn cơ bản [1]
- Phương pháp biến đổi đại số:
Đơn giản hóa câu truy vấn nhờ các phép biến đổi đại số tương đương nhằm giảm thiểu thời gian thực hiện các phép toán.
Phương pháp này không quan tâm đến kích thước và cấu trúc dữ liệu.
- Phương pháp ước lượng chi phí:
Xác định kích thước dữ liệu, thời gian thực hiện mỗi phép toán trong câu truy vấn.
Phương pháp này quan tâm đến kích thước dữ liệu và phải tính toán chi phí thời gian thực hiện mỗi phép toán.
2.1.5 So sánh xử lý truy vấn tập trung và phân tán[1]
– Tập trung:
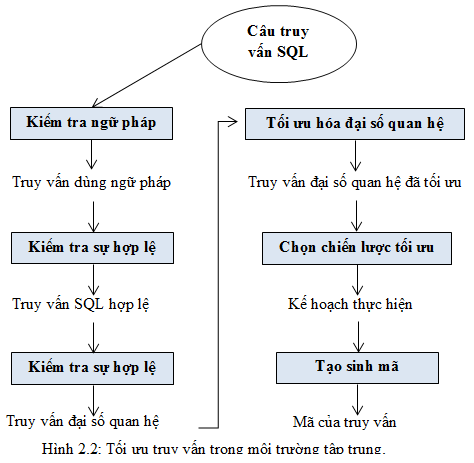
Chọn một truy vấn đại số quan hệ tốt nhất trong số các truy vấn đại số tương đương.
Các chiến lược xử lý truy vấn có thể biểu diễn trong sự mở rộng của đại số quan hệ.
Phân tán:
Kế thừa chiến lược xử lý truy vấn như môi trường tập trung ngoài, ra phải quan tâm thêm.
- Các phép toán truyền dữ liệu giữa các trạm.
- Chọn các trạm tốt nhất để xử lý dữ liệu.
- Cách truyền dữ liệu.
Thuật toán INGRES phân tán
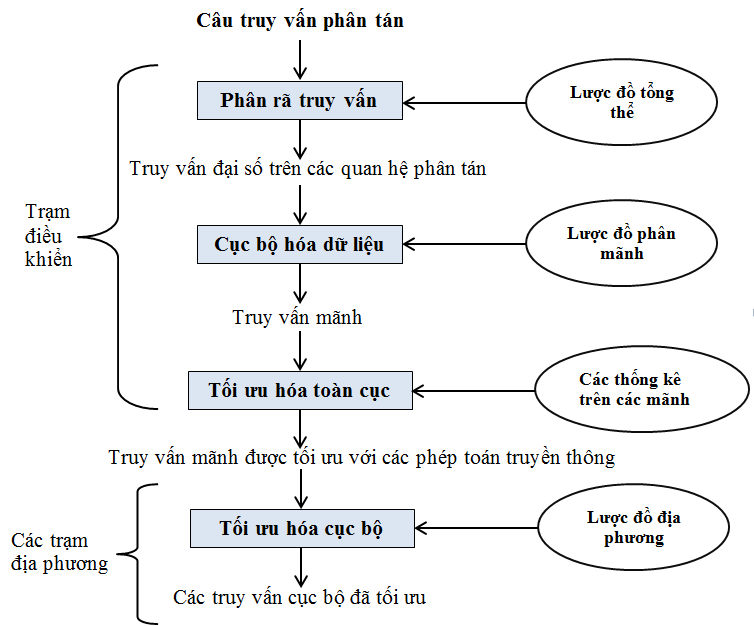
Hình 2.3: Sơ đồ phân lớp chung cho xử lý phân tán.
Thuật toán INGRES phân tán
Thuật toán tối ưu hoá câu truy vấn phân tán của INGRES phân tán bắt nguồn từ thuật toán INGRES tập trung. Hàm mục tiêu của thuật toán là tối thiểu tổng chi phí và thời gian trả lời, nhưng hai mục tiêu này đối lập nhau (tăng chi phí truyền thông, có thể giảm bớt thời gian trả lời) nên hai hàm mục tiêu có trọng số lớn hơn cho mục tiêu này hay mục tiêu kia. Thuật toán tối ưu hoá câu truy vấn này bỏ qua chi phí truyền dữ liệu tới trạm kết quả.Thuật toán sử dụng các phân đoạn ngang và xét cả hai kiểu mạng (mạng cục bộ và mạng diện rộng).
Đầu vào của thuật toán xử lý câu truy vấn là một câu truy vấn viết trong phép tính quan hệ bộ (trong dạng chuẩn hội) và thông tin lược đồ (kiểu mạng, vị trí và kích thước của mỗi đoạn). Thuật toán này được thực hiện tại trạm ở đó câu truy vấn được bắt đầu, gọi là trạm chủ (master site), thuật toán có tên D-INGRES-QOA[7].
Thuật toán: D-INGRES-QOA
Input: MVQ: Truy vấn đa biến với n biến
Output: Output: kết quả của truy vấn đa biến cuối cùng
BEGIN
For mỗi OVQi có thể tách ra in MVQ do {chạy tất cả các truy vấn một biến}
Run(OVQi); (1)
Endfor
MVQ’_list←REDUCE(MVQ;)
{thay thế MVQ bởi n truy vấn không thể rút gọn} (2)
While n≠0 do {n- số truy vấn không thể rút gọn} (3)
Begin
{Chọn truy vấn không thể rút gọn liên quan đến các đoạn nhỏ nhất}
MVQ’← select_query(MVQ’_list); (3.1)
{Xác định các đoạn để truyền và trạm xử lý MVQ’}
Fragment-site-list ←SELECT_STRATEGY(MVQ’); ( 3.2)
{truyền các đoạn đã chọn tới các trạm đã chọn}
For mỗi cặp (F,S) trong Fragment-site-list do (3.3)
Chuyển đoạn F tới trạm S;
End-for
Run(MVQ’);
n← n-1; (3.4)
End-while {đầu ra của thuật toán là kết quả của MVQ’ cuối cùng}
End. (D-INGRES-QOA)
2.2 Kết Luận
Chương này trình bày những khái niệm cơ bản về tối ưu hóa truy vấn phân tán, và các thuật toán tối ưu cơ bản như Distributed INGRES,…. Các hệ CSDL phân tán ban đầu thường chỉ dùng hàm mục tiêu cho các chi phí truyền theo kích thước được thông báo, trong thời gian gần đây vói sự phát triện đáng kể của các mạng “nhanh” thì chi phí xử lý cục bộ cũng được chú ý.
CHƯƠNG 3: CÀI ĐẶT VÀ THỬ NGHIỆM THUẬT TOÁN
3.1. Cài đặt thử nghiệm thuật toán tối ưu truy vấn trong cơ sở dữ liệu phân tán
Thuật toán INGRES đã mô tả dưới dạng giả mã (pseudocode) chương 2.Dữ liệu được sử dụng là CSDL về quản lý sinh viên của trường Cao đẳng Kiên Giang qua mạng Internet. Thông tin được lưu trong CSDL gồm thông tin về sinh viên, học phần, nhóm, kết quả quản lý qua mạng Internet.
| Bảng 1_SinhVien | |||||||
| Tên cột | Kiểu dữ liệu | Giải thích | |||||
| MaSoSinhVien | varchar(9) | Khóa chính | |||||
| HoLot | nvarchar(40) | Họ lót sinh viên | |||||
| Ten | nvarchar(20) | Tên sinh viên | |||||
| Phai | nvarchar(5) | Phái | |||||
| NgaySinh | char(10) | Ngày sinh | |||||
| NoiSinh | nvarchar(50) | Nơi sinh | |||||
| Bảng 2_ KetQua | |||||||
| Tên cột | Kiểu dữ liệu | Giải thích | |||||
| MaSoSinhVien | varchar(9) | Khóa chính | |||||
| MaNhom | char(14) | Khóa chính | |||||
| Diem | float | Điểm | |||||
| DiemChu | char(2) | Điểm chữ | |||||
| NgayNhap | char(10) | Ngày nhập | |||||
| NgayDieuChinh | char(10) | Ngày điều chỉnh | |||||
| GiangVienNhap | char(11) | Giảng viên nhập | |||||
| GiangVienDieuChinh | char(11) | Giảng viên điều chỉnh | |||||
| Bảng 3_Nhom | |||||||
| Tên cột | Kiểu dữ liệu | Giải thích | |||||
| MaNhom | char(14) | Khóa chính | |||||
| MaHocPhan | nvarchar(7) | Mã học phần | |||||
| NgayBatDau | char(10) | Ngày bắt đầu | |||||
| NgayKetThuc | char(10) | Ngày kết thúc | |||||
| SoSinhVienToiDa | int | Số sinh viên tối đa | |||||
| SoSinhVienToiThieu | int | Số sinh viên tối thiểu | |||||
| SoSinhVienHienTai | int | Số sinh viên hiện tại | |||||
| Dong | bit | Đóng | |||||
| Bảng 4_ HocPhan | |||||||
| Tên cột | Kiểu dữ liệu | Giải thích | |||||
| MaHocPhan | nvarchar(7) | Khóa chính | |||||
| TenHocPhan | nvarchar(50) | Tên học phần | |||||
| SoTinChi | smallint | Số tín chỉ | |||||
| MaKhoa | char(2) | Mã khoa | |||||
Sơ đồ quan hệ giữa các bảng như sau:
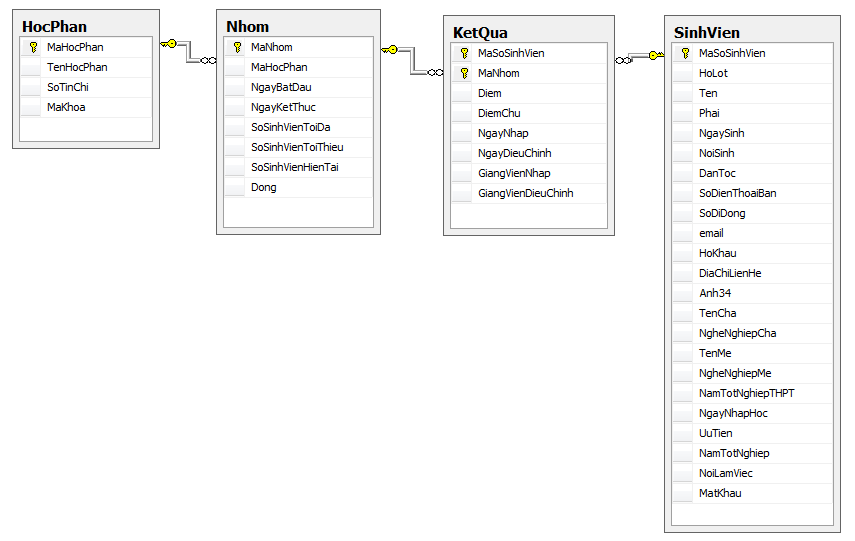
Hình 3.1: Sơ đồ quan hệ giữa các bảng
3.2.2 Xây dựng ứng dụng
Cấu hình máy: Gồm 2 server hệ điều hành Win 7, sử dụng dịch vụ IIS (Internet information services) để thiết lập Trạm 1 trở thành Web server với cơ sở dữ liệu là SQL server, Trạm 2 đóng vai trò máy lưu dữ liệu SQL server thứ hai, dữ liệu của hai trạm được liên kết với nhau nhờ chức năng Linked servers của SQL server
Ngôn ngữ để cài đặt ứng dụng: ASP.NET – C#.
Công cụ cài đặt ứng dụng: Microsoft VisualStudio 2015. Ứng dụng được thực hiện trên nền web, có thể hoạt động trên mạng WAN, hoặc LAN. Do ứng dụng chạy trên nền web, vì vậy ứng dụng có thể chạy trên các trình duyệt khác nhau của các hệ điều hành khác nhau
Ứng dụng cài đặt với 2 trạm.
- TRẠM 1: Database qldtBb, gồm 4 bảng HocPhan (433 bản ghi), Nhom (2.867 bản ghi), KetQua (113.187 bản ghi), bảng SinhVien (2.776 bản ghi)
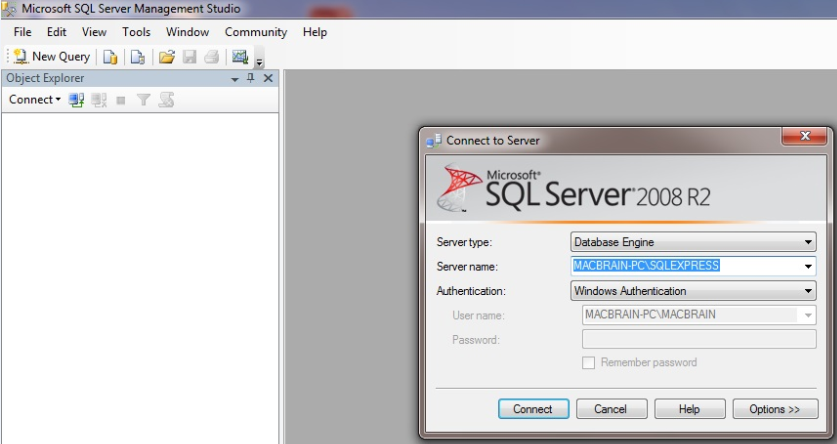
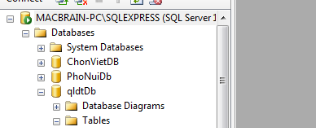
Hình 3.2. TRẠM 1: MACBRAIN-PC\SQLEXPRESS
TRẠM 2: Database qldtBb, gồm 4 bảng HocPhan (433 bản ghi) , Nhom (2.867 bản ghi), KetQua (113.187 bản ghi), bảng SinhVien (2.776 bản ghi)
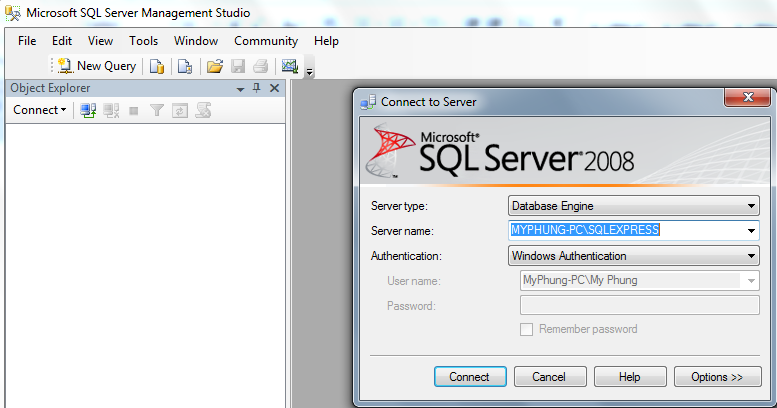
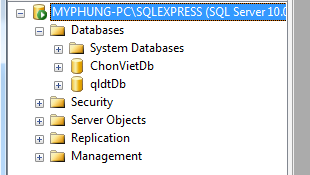
Hình 3.3. TRẠM 2: MYPHUNG-PC\SQLEXPRESS
Diễn giải các bước thực hiện của thuật toán.
Giả sử chúng ta lưu CSDL trên 2 server con. Khi đó thuật toán INGRES sẽ phân rã các truy vấn trên các server khác nhau và tổng hợp về để cải thiện tốc độ truy vấn.
Ta có câu truy vấn sau:
SELECT SinhVien.MaSoSinhVien, SinhVien.HoLot, SinhVien.Ten, HocPhan.MaHocPhan, HocPhan.TenHocPhan, KetQua.Diem
FROM SinhVien, KetQua, HocPhan,Nhom
WHERE SinhVien.MaSoSinhVien = KetQua. MaSoSinhVien
AND Nhom.MaNhom = KetQua. MaNhom
AND HocPhan.MaHocPhan = Nhom.MaHocPhan
Tách câu truy vấn trên thành các câu truy vấn nhỏ hơn và phân tán ở các máy trạm khác nhau. Trong thực tế có rất nhiều máy trạm khác nhau và câu truy vấn được phân rã ở nhiều nơi khác nhau (trong giới hạn demo chỉ ví dụ ở 2 máy trạm). Câu truy vấn này được đặt trên máy trạm 1.
SELECT kq.MaSoSinhVien, kq.MaNhom, kq.Diem INTO #temp1
FROM [TRAM1-PC\\SQLEXPRESS].qldtDb.dbo.KetQua as kq
WHERE kq.Diem drDiem.SelectedValue
SELECT hp.MaHocPhan, hp.TenHocPhan, nhom.MaNhom INTO #temp2 FROM [TRAM1-PC\\SQLEXPRESS].qldtDb.dbo.HocPhan as hp,[TRAM1- PC\\SQLEXPRESS].qldtDb.dbo.Nhom as nhom”
WHERE hp.MaHocPhan = nhom.MaHocPhan
SELECT #temp1.MaSoSinhVien, #temp1.Diem, #temp2.MaHocPhan, #temp2.TenHocPhan INTO #temp3
FROM #temp1, #temp2
WHERE #temp1.MaNhom = #temp2.MaNhom
SELECT #temp3.*, sv.HoLot, sv.Ten
FROM #temp3, [TRAM2-PC\\SQLEXPRESS].qldtDb.dbo.SinhVien as sv
WHERE sv.MaSoSinhVien = #temp3.MaSoSinhVien
drop table #temp1
drop table #temp2
drop table #temp3
Giao diện chính:
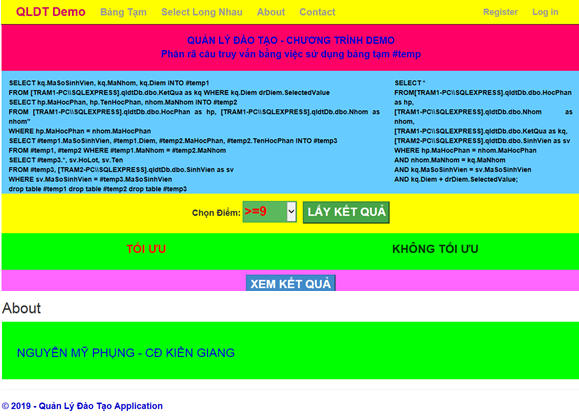
Hình 3.4: Giao diện chính
3.2.2.1. Thử nghiệm 1 (sử dụng bảng tạm temp)
Truy vấn với câu hỏi sau:
SELECT SinhVien.MaSoSinhVien, SinhVien.HoLot, SinhVien.Ten, HocPhan.MaHocPhan, HocPhan.TenHocPhan, KetQua.Diem
FROM SinhVien, KetQua, HocPhan,Nhom
WHERE SinhVien.MaSoSinhVien = KetQua. MaSoSinhVien
AND Nhom.MaNhom = KetQua. MaNhom
AND HocPhan.MaHocPhan = Nhom. MaHocPhan
AND KetQua.Diem >= 8
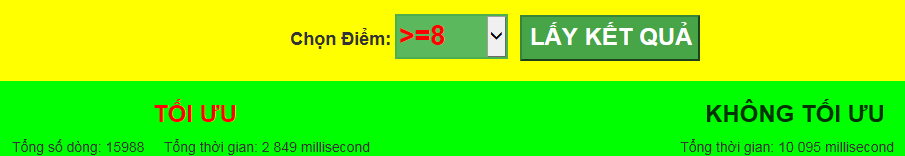
Hình 3.5. Lấy kết quả tất cả điểm của sinh viên>=8
Kết quả truy vấn trên máy TRẠM 1 với CSDL tập trung
(KHÔNG TỐI ƯU):
- Thời gian để thực hiện truy vấn và hiển thị là: 10 095 Miliseconds
- Số lượng bản ghi trả về là: 15 988
Kết quả truy vấn trên máy TRẠM 1 và TRẠM 2 với CSDL phân tán (TỐI ƯU):
- Thời gian để thực hiện truy vấn và hiển thị là: 2 849 Miliseconds
- Số lượng bản ghi trả về là: 15 988
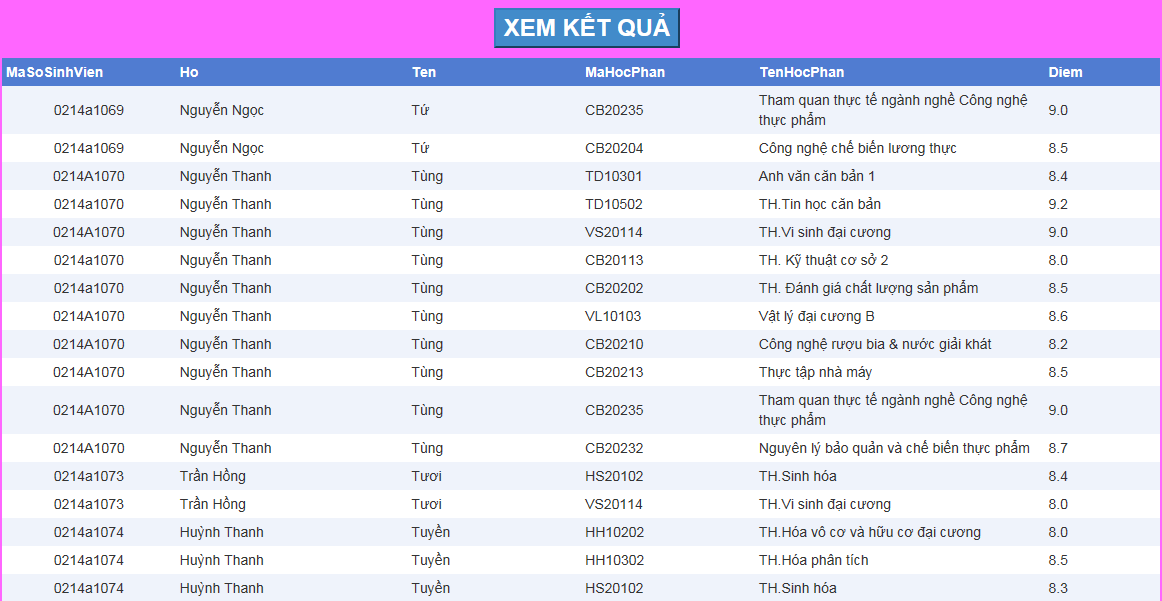
Hình 3.6: Xuất ra kết quả
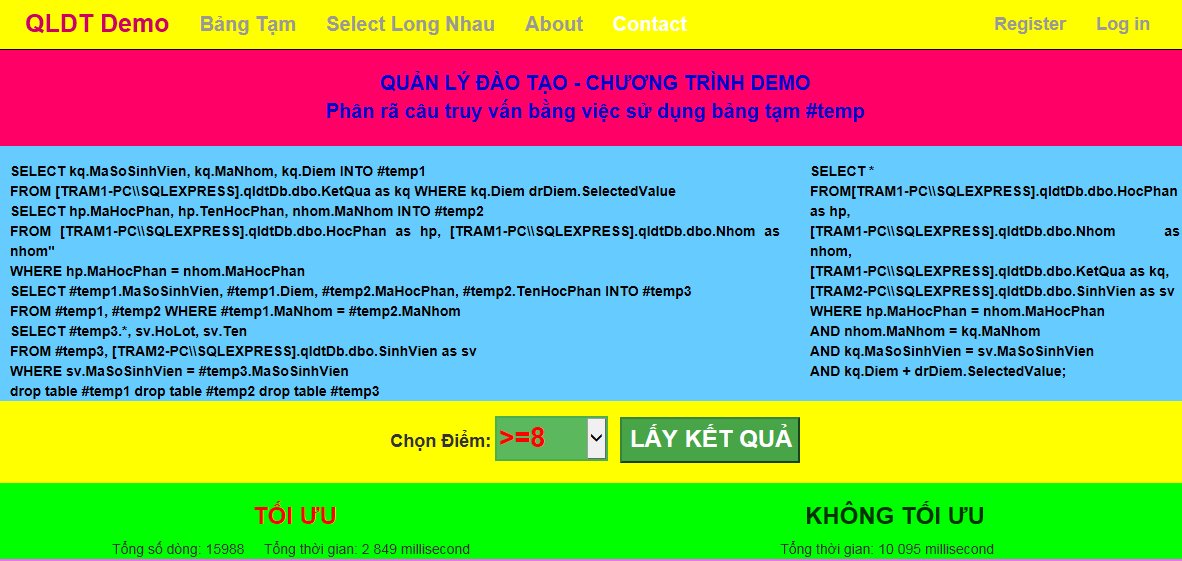
3.2.2.2. Thử nghiệm 2 (sử dụng SELECT lồng nhau)
Truy vấn với câu hỏi sau:
SELECT SinhVien.MaSoSinhVien, SinhVien.HoLot, SinhVien.Ten, HocPhan.MaHocPhan, HocPhan.TenHocPhan, KetQua.Diem
FROM SinhVien, KetQua, HocPhan,Nhom
WHERE SinhVien.MaSoSinhVien = KetQua. MaSoSinhVien
AND Nhom.MaNhom = KetQua. MaNhom
AND HocPhan.MaHocPhan = Nhom. MaHocPhan
AND KetQua.Diem >= 8
Truy vấn với CSDL tập trung:
- Thời gian để thực hiện truy vấn và hiển thị là: 2.777 Miliseconds
- Số lượng bản ghi trả về là: 15988
Truy vấn với CSDL phân tán:
- Thời gian để thực hiện truy vấn và hiển thị là: 1,404 Miliseconds
Số lượng bản ghi trả về là: 15.988
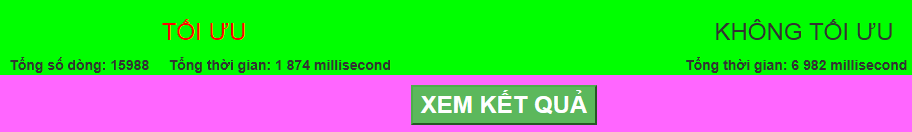
Hình 3.8. Lấy kết quả tất cả điểm của sinh viên>=8
Kết quả truy vấn trên máy TRẠM 1 với CSDL tập trung
(KHÔNG TỐI ƯU):
- Thời gian để thực hiện truy vấn và hiển thị là: 6 982 Miliseconds
- Số lượng bản ghi trả về là: 15 988
Kết quả truy vấn trên máy TRẠM 1 và TRẠM 2 với CSDL phân tán (TỐI ƯU):
- Thời gian để thực hiện truy vấn và hiển thị là: 1 874 Miliseconds
- Số lượng bản ghi trả về là: 15 988
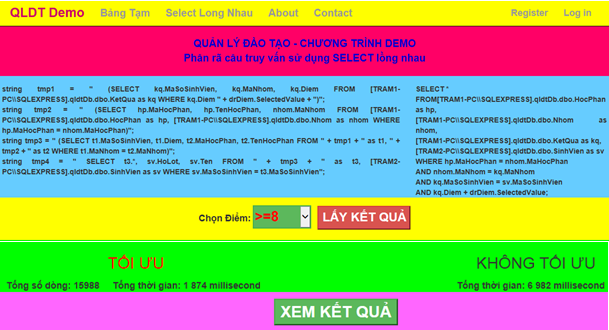
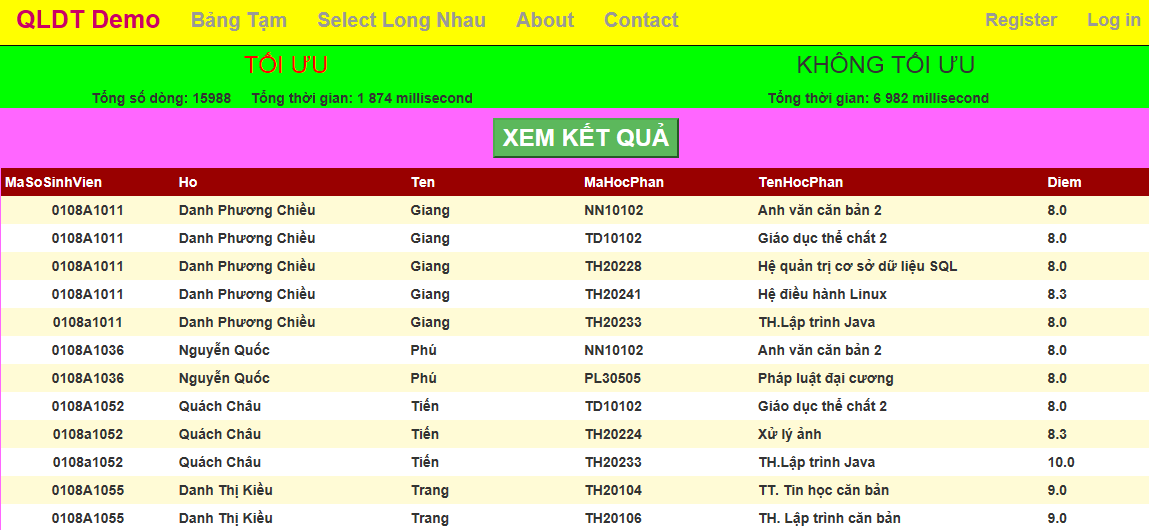
Phần tối ưu của CSDL phân tán dữ liệu được truy xuất từ TRẠM 1: gồm 3 bảng HocPhan (433 bản ghi), Nhom (2.867 bản ghi), KetQua (113.187 bản ghi) và TRẠM 2: Gồm bảng SinhVien (2.776 bản ghi) khi người sử dụng (User) truy xuất dữ liệu sẽ không biết rõ vị trí của các bảng nằm ở đâu truy xuất từ trạm nào là do tính trong suốt của CSDLPT .
3.3 Kết luận
Đề tài đã cài đặt thuật toán INGRES để xử lý phân tán câu hỏi và lựa chọn được phương án xử lý câu hỏi phân tán với chi phí tối ưu từ các máy trạm.
Ứng dụng cho phép thực hiện :
- Thực hiện câu truy vấn trên từng máy trạm.
- Thực hiện câu truy vấn trên CSDL tập trung.
- Cho phép thực hiện các câu truy vấn đơn giản phân tán trên 2 máy trạm thực hiện cài đặt với thuật toán INGRES
- Đưa ra thời gian thực hiện các câu truy vấn trên CSDL tập trung và phân tán để so sánh
- Ngoài ra đề tài cho phép thực hiện phân tán với các câu truy vấn lồng.
Mặt hạn chế về chương trình
- Quá trình tích hợp dữ liệu có được từ các máy trạm do đường truyền không ổn định, nên đường truyền từ các máy trạm xảy ra sự cố thời gian tối ưu của CSDLPT không phải lúc nào cũng ít hơn thời gian không tối ưu so với CSDL tập trung.
KẾT LUẬN VÀ HƯỚNG PHÁT TRIỂN CỦA ĐỀ TÀI
- Kết luận
Việc lựa chọn một giải pháp khả thi để thực hiện phân tán cơ sở dữ liệu sao cho phù hợp với yêu cầu thực tế là một bước quan trọng khởi đầu khi xây dựng một hệ phân tán. Một giải pháp phân tán dữ liệu phù hợp sẽ làm tăng tốc độ xử lý dữ liệu và mang lại hiệu quả kinh tế cao.
Với đề tài “Tối ưu hóa truy vấn trong cơ sở dữ liệu phân tán”, luận văn đã trình bày được một cách hệ thống một số nội dung sau:
- Giới thiệu những thuật toán tối ưu truy vấn trong cơ sở dữ liệu phân tán phổ biến như: thuật toán INGRES phân tán
- Cài đặt chương trình ứng dụng thuật toán INGRES tối ưu truy vấn trong cơ sở dữ liệu phân tán về quản lý sinh viên của trường Cao đẳng Kiên Giang
2. Hướng phát triển của đề tài:
Trong thời gian tới, hướng phát triển của đề tài tập trung làm rõ hơn về phân tán dữ liệu và xây dựng ứng dụng phân tán cũng như cải tiến các thuật toán để đạt được kết quả cao hơn.
- Phân tích sâu sắc hơn về các thuật toán INGRES phân tán để có thể cho một đánh giá về độ phức tạp của thuật toán đó là khuyến cáo trong trường hợp nào nên dùng thuật toán nào sẽ hiệu quả.
- Nghiên cứu phương pháp kết hợp thuật toán tối ưu đàn kiến và quy hoạch động để tối ưu hóa truy vấn trong CSDL phân tán hiệu quả hơn.
- Trình bày, phân tích phương pháp tối ưu hoá bằng Heuristic, nghiên cứu sâu và kỹ hơn nữa rồi tiến hành cài đặt các phương pháp này.
- Thực hiện tối ưu hóa truy vấn dựa theo đặc tính riêng của từng loại cơ sở dữ liệu, tìm ra được những phương pháp tối ưu tốt nhất cho từng loại CSDL khác nhau. Tìm các giải pháp mã hóa dữ liệu để lưu trữ tối ưu và truy vấn tối ưu.
E:\DỮ LIỆU COP CỦA CHỊ YẾN\LUAN VAN DUY TAN\LUAN VAN DUY TAN\LUAN VAN CO TUYET\LUAN VAN CO TUYET\LUAN VAN CO TUYET\LUAN VAN CO TUYET\r.NGUYEN MY PHUNG\SAU BAO VE


