Phân tích trải nghiệm khách hàng trực tuyến trong lĩnh vực khách sạn tiếp cận theo mô hình chủ đề
CHƯƠNG 1: TỔNG QUAN ĐỀ TÀI
Trong chương này, luận văn trình bày cơ sở hình thành đề tài, các mục tiêu, đối tượng và phạm vi nghiên cứu. Phương pháp nghiên cứu, đóng góp của đề tài và kết cấu luận văn được trình bày ở cuối chương.
Cơ sở hình thành đề tài
Trải nghiệm khách hàng hay Customer Experience Management (CEM) là một quá trình quản lý mọi trải nghiệm mà khách hàng, đối tác của doanh nghiệp có thể có với sản phẩm, dịch vụ và thương hiệu mà doanh nghiệp cung cấp hay các dịch vụ hỗ trợ đi kèm (Hình 1.1). Đó có thể là cảm xúc, cảm giác, hay những suy nghĩ, bình luận, và phản hồi để dẫn tới các hành động trung thành hay rời bỏ rồi chuyển sang mua hàng hoặc sử dụng dịch vụ ở một doanh nghiệp khác.
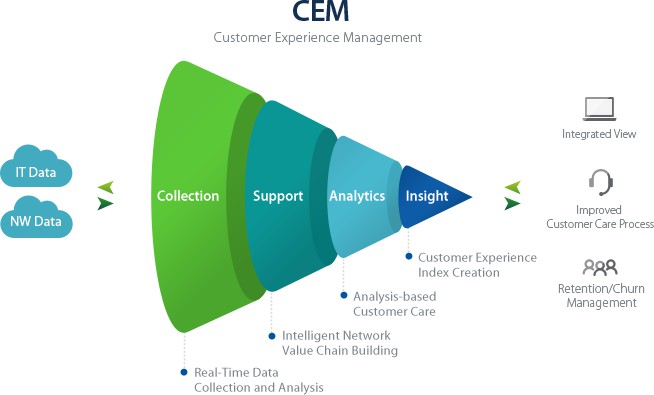
Hình 1.1: Chiến lược Trải nghiệm khách hàng
(Nguồn: https://www.brandsvietnam.com)
Trải nghiệm khách hàng là toàn bộ quá trình tương tác của khách hàng với doanh nghiệp, từ giây phút khách hàng biết đến tên của doanh nghiệp, tìm kiếm thông
tin, cân nhắc, gặp gỡ, mua hàng, sau mua hàng và những lần mua hàng sau. Các mẫu quảng cáo, trang web, văn phòng (văn bản, fly, brochure…), tất cả các điểm tiếp xúc (touchpoint) cũng như dịch vụ doanh nghiệp phải mang lại cho khách hàng những cảm xúc tích cực. Do đó, để khách hàng đồng cảm và hiểu rõ doanh nghiệp, nhà quản trị phải thực sự thân thiện với khách hàng từ những sản phẩm nhỏ nhất như brochure, bản tin doanh nghiệp, tên gọi sản phẩm, logo, bao bì hay đội ngũ giao hàng. Chính sự kết hợp có tổ chức của các công cụ cơ bản của quảng cáo sẽ tạo ra sự hiện diện nổi bật của doanh nghiệp. Trong chiến lược trải nghiệm khách hàng, các doanh nghiệp cần: (1) Đánh giá mức độ hài lòng của khách hàng, (2) Thu thập và phân tích phản hồi của khách hàng, (3) Thiết kế trải nghiệm khách hàng, (4) Không ngừng tương tác với khách hàng (Peppers và Rogers, 2016).
Trong nhiều năm trở lại đây, trải nghiệm khách hàng đang trở thành một trong những yếu tố hàng đầu để tạo nên lợi thế cạnh tranh cho doanh nghiệp. Doanh nghiệp nào muốn có được trái tim của khách hàng, chắc chắn doanh nghiệp đó sẽ phải sử dụng hình thức này. Sự gia tăng nhanh chóng của số lượng người sử dụng Internet và điện thoại thông minh trong những thập kỷ qua đã làm cho mọi người linh hoạt hơn và dễ dàng hơn khi truy cập các dịch vụ trực tuyến hay mạng xã hội. Điều này dẫn đến các công ty lựa chọn các trang web, mạng xã hội trở thành công cụ tiếp thị và tiếp nhận phản hồi của khách hàng; và là một kênh rất hiệu quả. Thông qua mạng xã hội, trang web khách hàng cũng sẽ thuận tiện hơn khi phản hồi hoặc đóng góp ý kiến cho công ty, viết nhận xét và đánh giá sản phẩm cũng như chia sẻ thông tin về một sản phẩm, dịch vụ hoặc thương hiệu. Gần đây, trên các phương tiện truyền thông hay kinh doanh trực tuyến khách hàng thường đưa ra hoặc xem qua rất nhiều bình luận, đánh giá, bài viết blog hay mẩu tin trực tuyến (Bucur, 2015; Putri và Kusumaningrum, 2017). Các dữ liệu này được lưu trữ dưới dạng văn bản không cấu trúc (Boyd-Graber và Mimno, 2017). Vấn đề là với khối lượng lớn nội dung văn bản này thì chúng ta không thể đọc tất cả nội dung đó. Do vậy, chúng ta cần một cách tiếp cận để “tóm tắt” khối lượng dữ liệu văn bản này thành các đặc điểm sâu sắc, chẳng hạn như chủ đề của các bình luận hoặc ý kiến, hoặc những đánh giá trực tuyến
về sản phẩm, dịch vụ đang nói đến, tức là, những “chủ đề” mà khách hàng đang quan tâm. Bên cạnh đó, có thể chất lượng sản phẩm lại không như trên hệ thống, như mô tả trên cửa hàng trực tuyến nên một số khách hàng đưa ra nhận xét, ý kiến bình luận là để những người mua hàng sau biết được. Nhiều công ty lớn đang sử dụng phương tiện truyền thông, quảng cáo trên trang web, mạng xã hội để củng cố mối quan hệ với khách hàng, gia tăng lòng trung thành, tìm kiếm khách hàng mới cũng như xây dựng thương hiệu thông qua cộng đồng mạng, đánh giá của người dùng trên các kênh trực tuyến. Chính vì vậy, nguồn thông tin mà nhiều người thường xuyên tham khảo để dẫn đến quyết định mua hàng thường là những bình luận của khách hàng đã trải nghiệm sản phẩm và dịch vụ để lại trên các kênh trực tuyến.
Để giải quyết các vấn đề trên nhằm hiểu được những trải nghiệm của khách hàng và xây dựng những chiến lược kinh doanh hiệu quả hơn, phương pháp tiếp cận theo mô hình chủ đề (Topic modeling) được nhiều công trình nghiên cứu quan tâm khi phân tích dữ liệu và rút trích thông tin đặc biệt trong nhiều lĩnh vực như khách sạn (Bjørkelund và cộng sự, 2012), giáo dục (Hồ Trung Thành và Đỗ Phúc, 2014), bán hàng trực tuyến (Ma và cộng sự, 2013; Santosh và cộng sự, 2016), du lịch (Putri và Kusumaningrum, 2017; Rossett và cộng sự, 2016), y sinh (Liu và cộng sự, 2016), hay nhà ở (Sutherland và cộng sự, 2020). Các chủ đề mà các ý kiến, quan điểm của cá nhân khi đưa ra các nhận xét bình luận hay phản hồi về các dịch vụ sản phẩm của doanh nghiệp rất đa dạng phong phú, do đó khám phá chủ đề là rút trích được thông tin quan trọng, nắm bắt được thói quen, hành vi của cá nhân hay cộng đồng trên mạng. Tuy nhiên, đối với tính chất của mạng trực tuyến thì chủ đề của nội dung thông điệp trao đổi chưa được tạo trước hay nói cách khác chủ đề được trao đổi trên diễn đàn mạng là tiềm ẩn (Nguyen Muon và cộng sự, 2013). Chính vì vậy, việc khám phá chủ đề và hiểu được nội dung thông điệp trao đổi của khách hàng là một thách thức lớn và là bài toán khó (Alghamdi và Alfalqi, 2015).
Với nghiên cứu này, các chủ đề ẩn mà khách hàng đã đưa ra trong các ý kiến, đánh giá về các dịch vụ khách sạn được phát hiện, từ đó chúng ta nắm bắt được những vấn đề mà khách hàng quan tâm. Khách hàng có thể dựa vào phân loại bình luận, cảm
xúc khách hàng để chọn nơi lưu trú tốt nhất, hợp với mình nhất. Bên cạnh đó góc độ doanh nghiệp, họ sẽ thấy được khách hàng không hài lòng với điểm nào để khắc phục nâng cao chất lượng sản phẩm và dịch vụ. Bên cạnh đó, trong nghiên cứu này chỉ số Net Promoter Score (NPS) phân tích từ điểm số đánh giá của người dùng đối với dịch vụ của công ty được tính toán và phân tích. Và với những vấn đề đã tìm ra, với kết quả chỉ số NPS thì đối với các doanh nghiệp có thể dùng một chiến dịch quảng cáo thông qua thư điện tử thì họ có thể giữ chân khách hàng, thậm chí nâng cao sự hài lòng của khách hàng hiện có, thu hút khách hàng mới hay là gia tăng tỷ lệ chuyển đổi thành khách hàng khi áp dụng một chính sách kinh doanh phù hợp với sản phẩm, dịch vụ mục tiêu với đúng khách hàng (Rossetti và cộng sự, 2016).
Tóm lại, dữ liệu ý kiến bình luận của khách hàng là vô cùng nhiều không thể đọc bằng mắt thường vì sẽ mất rất nhiều thời gian, công sức để phân loại đánh giá được, vì vậy một mô hình thu thập, phân tích văn bản, phân loại chủ đề bình luận khách hàng là cần thiết, việc rút trích các chủ đề ẩn và phân loại chúng giúp nhà quản lý đọc hiểu, lựa chọn và tìm kiếm những thông tin có nội dung xác định nhanh và chính xác hơn để ra quyết định. Hướng nghiên cứu của đề tài là sự kết hợp của kiến thức liên ngành bao gồm kinh tế, quản lý, marketing, và hệ thống thông tin cũng như các kỹ thuật trong phân tích dữ liệu như thu thập, trích xuất dữ liệu, xử lý dữ liệu văn bản, xử lý ngôn ngữ tự nhiên, lập trình Python, học máy, quản lý trải nghiệm khách hàng.
Mục tiêu nghiên cứu
Đề xuất mô hình khai phá ý kiến trải nghiệm của khách hàng thông qua chủ đề quan tâm tiềm ẩn trong các bình luận trên các trang thương mại điện tử trong lĩnh vực khách sạn và ứng dụng phương pháp Net Promoter Score đánh giá mức độ hài lòng của khách hàng để hỗ trợ ra quyết định trong kinh doanh quản lý.

Mục tiêu cụ thể của đề tài là:
- Xây dựng mô hình thu thập và xử lý dữ liệu văn bản là các ý kiến bình luận trực tuyến của khách hàng trong lĩnh vực khách sạn.
- Thực nghiệm xác định số chủ đề K, ứng dụng mô hình chủ đề để khám phá chủ đề quan tâm và tập từ khóa thường xuất hiện (đồng hiện).
- Gán nhãn các chủ đề.
- Xây dựng mô hình chủ đề kết hợp yếu tố thời gian.
- Xây dựng chỉ số NPS dựa vào điểm đánh giá của khách hàng.
- Sau đó nhận dạng được các vấn đề khách hàng đang quan tâm và có những khuyến nghị giúp cho cửa hàng kinh doanh có thể cải thiện chất lượng sản phẩm, dịch vụ từ đó có chiến lược để thu hút và giữ chân khách hàng tốt hơn.
Đối tượng và phạm vi nghiên cứu
Đối tượng nghiên cứu: Các phương pháp, mô hình khai phá ý kiến từ văn bản nói chung và trong ngôn ngữ tiếng Anh nói riêng. Khai phá ý kiến người dùng tiếp cận theo mô hình chủ đề. Các bình luận, các đánh giá của khách hàng trên trang web Agoda.vn và Booking.com.
Phạm vi nghiên cứu: Các dữ liệu nghiên cứu và xây dựng mô hình thực nghiệm được thu thập từ hai trang web thương mại điện tử trong lĩnh vực khách sạn gồm: Agoda.vn và Booking.com trong khoảng thời gian từ năm 2009 đến năm 2020.
Phương pháp nghiên cứu
Phương pháp nghiên cứu định tính: khảo sát và nghiên cứu dữ liệu thứ cấp từ các nghiên cứu trước đây để tổng hợp các kỹ thuật khai phá ý kiến đối với các ngôn ngữ khác nhau trên thế giới, đánh giá ưu và nhược điểm của các kỹ thuật. Từ đó, đề xuất phương pháp tiếp cận và mô hình phân tích trải nghiệm của khách hàng trực tuyến dựa theo mô hình chủ đề.
Phương pháp nghiên cứu thực nghiệm: phương pháp được áp dụng để thực hiện thu thập và tiền xử lý dữ liệu người dùng từ các trang thương mại điện tử trong lĩnh vực khách sạn, từ đó xây dựng mô hình chủ đề để khám phá và phân tích các chủ đề ẩn, ứng dụng mô hình chỉ số NPS để đo lường mức độ hài lòng của khách hàng và đưa ra hàm ý về ứng dụng kết quả nghiên cứu trong kinh doanh và quản lý.
Quy trình nghiên cứu
Nghiên cứu được thực hiện theo sơ đồ như Hình 1. 
Xác định vấn đề nghiên cứu
Xác định mục tiêu, đối tượng, phạm
vi, phương pháp nghiên cứu
Khảo sát các cơ sở lý thuyết liên quan
Khảo sát các nghiên cứu liên quan
Thu thập dữ liệu, làm sạch dữ liệu
Kết luận, kiến nghị
Phân tích kết quả thực nghiệm
Xây dựng và đánh giá mô hình thực nghiệm
Hình 1.2: Sơ đồ quy trình nghiên cứu
(Nguồn: Đề xuất của tác giả)
Đóng góp của nghiên cứu
Nghiên cứu đề xuất mô hình và phương pháp thu thập, đánh giá các ý kiến khách hàng trực tuyến, tìm ra các chủ đề khách hàng đang quan tâm trao đổi. Mô hình chỉ số NPS hỗ trợ trải nghiệm khách hàng. Qua đó kết quả nghiên cứu mang lại giá trị cho doanh nghiệp, cung cấp thông tin tri thức để khuyến nghị cho doanh nghiệp đang kinh doanh trong lĩnh vực khách sạn có chính sách cải thiện chất lượng sản phẩm và dịch vụ tốt hơn.
Cụ thể là, luận văn này đã giải quyết được bốn vấn đề quan trọng đóng góp về mặt khoa học và thực tiễn trong lĩnh vực phân tích trải nghiệm khách hàng trực tuyến:
Thứ nhất là khảo sát các nghiên cứu liên quan đến lĩnh vực khách sạn, các phương pháp phân tích ý kiến khách hàng, đặc biệt là khách hàng tương tác trên các kênh thông tin trực tuyến. Các hạn chế của các kênh truyền thống, và ưu thế của việc khai phá ý kiến bình luận trực tuyến để thấu hiểu khách hàng.
Thứ hai là xây dựng phương pháp thu thập, khai phá, phân tích ý kiến người dùng dựa theo mô hình chủ đề có yếu tố thời gian và phân tích sự biến thiên của tập chủ đề theo thời gian. Áp dụng mô hình chủ đề LDA huấn luyện dữ liệu văn bản trong tập ngữ liệu thu thập được, để xác định số chủ đề tối ưu cho mô hình. Phương pháp tổng hợp từ khóa dùng để gán nhãn các chủ đề đã được rút trích. Từ đó, phương pháp này giúp tìm ra các chủ đề mà khách hàng đang quan tâm, trao đổi trong từng giai đoạn thời gian, và cụ thể là chủ đề nào được quan tâm và mức độ quan tâm.
Thứ ba là để thực nghiệm các mô hình và phương pháp, nghiên cứu đã thử nghiệm và đánh giá mô hình và phương pháp trên tập dữ liệu ý kiến khách hàng viết bằng tiếng Anh được thu thập từ hai trang web thương mại điện tử trong lĩnh vực khách sạn là Booking.com và Agoda.vn.
Thứ tư là phân tích và xây dựng mô hình chỉ số Net Promoter Score dựa vào dữ liệu đánh giá của khách hàng đối với sản phẩm dịch vụ của công ty. Chỉ số NPS giúp doanh nghiệp phân loại khách hàng thành ba nhóm: Promoters (P), Passives (P) và Detractors (D).
Kết quả thực nghiệm đã cho thấy được tính ứng dụng của luận văn và khả năng khai thác hiệu quả của mô hình ứng dụng vào thực tế. Đặc biệt, kết quả trực quan rất hữu ích cho các nhà quản lý doanh nghiệp, những người không chuyên về kỹ thuật có thể dễ dàng nắm bắt, hỗ trợ ra quyết định kịp thời và chính xác.
Kết cấu luận văn
Luận văn được thể hiện trong 6 chương.
Chương 1: Tổng quan đề tài trình bày tổng quan về đề tài bao gồm cơ sở hình thành đề tài, bối cảnh nghiên cứu, mục tiêu nghiên cứu, đối tượng, phạm vi và phương pháp nghiên cứu và ý nghĩa thực tiễn cũng như các đóng góp chính của đề tài.
Chương 2: Tổng quan tình hình nghiên cứu trình bày về tình hình nghiên cứu như khai phá ý kiến người dùng trực tuyến bao gồm các khái niệm tổng quan, các kỹ thuật khai phá ý kiến người dùng, và đặc trưng của khai phá ý kiến người dùng trong ngôn ngữ tiếng Anh tiếp cận theo mô hình chủ đề. Chỉ số NPS trong quản lý trải nghiệm khách hàng. Và các nghiên cứu có liên quan trong nước và trên thế giới.
Chương 3: Cơ sở lý thuyết, chương này trình bày về cơ sở lý thuyết và tổng quan các mô hình chủ đề, chỉ số NPS được áp dụng trong mô hình thực nghiệm khai phá dữ liệu người dùng. Trong chương này, luận văn cũng trình bày phương pháp thực nghiệm của quá trình nghiên cứu bao gồm các bước xử lý dữ liệu, thiết kế mô hình khai phá dữ liệu theo mô hình chủ đề.
Chương 4: Xây dựng mô hình thực nghiệm, ở phần này, luận văn tập trung trình bày về các bước xử lý trong mô hình bao gồm quá trình thu thập dữ liệu, tiền xử lý dữ liệu, xây dựng mô hình chủ đề, gán nhãn chủ đề, phân tích mô hình với yếu tố thời gian. Xử lý và phân tích chỉ số NPS dựa vào điểm đánh giá (rating) của khách hàng.
Chương 5: Kết quả nghiên cứu và thảo luận trình bày tóm tắt kết quả đạt được của nghiên cứu. Sau quá trình xử lý, các chủ đề ẩn được trích xuất, từ đó đưa ra các hàm ý được sử dụng hỗ trợ ra quyết định trong quản lý kinh doanh ở các doanh nghiệp trong lĩnh vực khách sạn. Kết quả chỉ số NPS được sử dụng hữu ích trong việc đánh giá sự hài lòng của khách hàng.
Chương 6: Kết luận và hướng phát triển, trình bày kết luận, những đóng góp của nghiên cứu, các hạn chế còn tồn tại và đề xuất hướng phát triển tiếp theo của đề tài.
CHƯƠNG 2: TỔNG QUAN TÌNH HÌNH NGHIÊN CỨU
CHƯƠNG 3: CƠ SỞ LÝ THUYẾT
Chương ba trình bày về cơ sở lý thuyết được sử dụng để làm cơ sở khoa học cho đề tài nghiên cứu. Lý thuyết về mô hình chủ đề, mô hình chủ đề theo thời gian và mô hình chỉ số NPS được trình bày trong chương này.
Mô hình chủ đề
Trước đây, phương pháp Term Frequency – Inverse Document Frequency (TF – I DF) (Jones, 1972) được sử dụng khá phổ biến để mã hóa văn bản thành véc tơ. Tức là một tập hợp các từ được lựa chọn trước hay còn gọi là túi từ (bag of word – BoW) sao cho những từ này không phải là từ dừng hay hư từ (stopwords) và với mỗi một văn bản (document) chúng ta sẽ đo lường tần suất xuất hiện của chúng. Những tần suất này sau đó sẽ được so sánh với tần suất văn bản xuất hiện trong toàn bộ văn bản (corpus). Từ đó ta tính được chỉ số TF – IDF của từng từ trong tập BoW.
w tf
log N
(3.1)
i, j i, j df
j
Trong công thức (3.1), ta có:
N: tổng số lượng tài liệu
tf: số lần xuất hiện của từ trong tài liệu
df: số tài liệu có chứa từ
w: chỉ số TF – IDF
Chỉ số TF – IDF sẽ giúp tìm được những từ có ý nghĩa quan trọng trong tập văn bản và loại bỏ những từ ít quan trọng và “từ thông thường” thông qua giá trị của TF – IDF càng lớn đối với những từ quan trọng. Kết quả sau cùng là thu được một ma trận văn bản – từ (ma trận X) sao cho mỗi cột của ma trận sẽ chứa các giá trị TF – IDF đại diện cho một văn bản trong tập ngữ liệu và mỗi dòng đại diện cho một từ. Do đó, ta có thể coi TF – IDF là một phương pháp giảm chiều dữ liệu. Có thể thấy TF – IDF có một số đặc trưng rất tốt đặc biệt là trong xác định tập hợp các từ có ảnh hưởng
lớn đến phân biệt nội dung các văn bản. Tuy nhiên, “phương pháp này vẫn còn một số điểm yếu như số lượng chiều giảm thiểu là không đáng kể và cung cấp rất ít về những thông tin cấu thành bên trong của văn bản như các chủ đề và nhân tố ẩn bên trong” (Phạm Đình Khánh, 2019).
Mô hình Latent Semantic Analysis (LSA)
Để khắc phục những hạn chế của phương pháp TF – IDF các nhà nghiên cứu đã đề xuất một phương pháp là latent semantic analysis (LSA) – phân tích ngữ nghĩa ẩn (Deerwester và cộng sự,1990) dựa trên phép phân tích suy biến ma trận X để xác định một không gian tuyến tính con của TF – IDF mà vẫn giữ được hầu hết những biến động của ma trận X. Giả sử ma trận biểu diễn mối quan hệ giữa tài liệu – từ là Amn ∈ Rmxn. Về cơ bản, phép phân tích suy biến sẽ biến đổi ma trận gốc A thành tích của các ma trận suy biến trái U, ma trận đường chéo S và ma trận suy biến phải V theo công thức (3.2) (Phạm Đình Khánh, 2019):
A U
VT
(3.2)
mn mt tt nt
Trong đó t là tham số số lượng chủ đề được lựa chọn. Khi đó:
- Ma trận U ∈ Rmxt là ma trận tài liệu – từ.
- Ma trận V ∈ Rnxt là ma trận từ – chủ đề.
- Mỗi dòng của U sẽ biểu diễn phân phối của văn bản và mỗi dòng của V là phân phối của mỗi từ theo t chủ đề ẩn.
- Các cột của U và V đại diện cho các chủ đề.
- Để tìm ra hai văn bản có giống nhau hoặc hai từ giống nhau chúng ta sẽ tính tương quan của các véc tơ dòng tương ứng với các văn bản của ma trận U hoặc các véc-tơ dòng tương ứng với từ của ma trận V.
Phép phân tích này giảm được khá nhiều chiều đối với trường hợp bộ văn bản lớn. Tuy nhiên nó vẫn tồn tại những nhược điểm đó là:
- Các tính toán hoàn toàn dựa trên phân tích ma trận.
- Các chủ đề được xác định dựa trên các phép chiếu tuyến tính nên mối quan hệ giữa chủ đề-tài liệu và chủ đề-từ là tuyến tính.
- Chi phí tính toán của mô hình rất tốn kém nếu kích thước dữ liệu lớn.
Mô hình Probabilistic Latent Semantic Analysis (pLSA)
Thay vì sử dụng ma trận như mô hình LSA, mô hình probabilistic latent semantic analysis (pLSA) (Hofmann, 1999) sử dụng phương pháp xác suất. Đồ thị mô hình có dạng như hình 3.1.

Hình 3.1: Đồ thị sinh xác suất của mô hình pLSA (Hofmann, 1999).
Xét các quan sát dưới dạng đồng xuất hiện của các cặp (w,d) của tài liệu – từ, pLSA sẽ mô hình hóa xác suất đồng xuất hiện của mỗi cặp (w,d) như một hỗn hợp của phân phối multinomial độc lập có điều kiện (Phạm Đình Khánh, 2019):
p(w, d ) p(c) p(d | c) p(w | c) p(d ) p(c | d ) p(w | c)
c c
(3.3)
- Như vậy xác suất đồng xuất hiện của một cặp tài liệu – chủ đề sẽ được xác định thông qua phân phối xác suất của chủ đề theo các văn bản p(c|d) và phân phối xác suất của các từ theo chủ đề p(w|c).
- p(d), p(c|d), p(w|c) là các tham số của mô hình, p(d) có thể được xác định trực tiếp từ bộ văn bản, p(c|d) và p(w|c) là các phân phối multinomial được huấn luyện từ mô hình thông qua phương pháp tối đa hóa kỳ vọng – Expectation Maximization (EM).
- Bên cạnh đó xác suất đồng xuất hiện p(w,d) cũng có thể được biểu diễn thông qua phân phối xác suất của từ theo chủ đề (p(w|c)) và của văn bản theo chủ đề (p(d|c)). Trường hợp này sẽ tương tự như mô hình LSA. Khi đó p(d|c) sẽ tương
ứng với ma trận suy biến trái U, p(w|c) tương ứng với ma trận suy biến phải V, p(c) chính là ma trận đường chéo chính Σ.
- Quá trình hồi quy pLSA như một quá trình sinh dựa trên một đồ thị. Bước đầu tiên của mô hình có thể xuất phát với chủ đề hoặc tài liệu. Nếu chúng ta bắt đầu với văn bản đầu tiên chúng ta tạo ra các phân phối của văn bản p(d), sau đó sinh ra phân phối chủ đề ngẫu nhiên p(z|d), và tiếp theo tạo ra phân phối của các từ p(w|z) dựa trên chủ đề. Nếu bắt đầu bằng chủ đề thì chúng ta sẽ sinh ra các chủ đề ngẫu nhiên, tiếp theo là hai quá trình đồng thời tạo ra văn bản và từ dựa trên chủ đề. Cụ thể của quá trình này như Hình 3.2 bên dưới:

Hình 3.2: Quá trình sinh của mô hình pLSA
(Nguồn: https://phamdinhkhanh.github.io)
Mặc dù dựa trên mô hình sinh xác suất đồ thị nên có tính linh hoạt cao hơn so với LSA nhưng mô hình pLSA vẫn có những hạn chế đó là:
- Không xác định được trước tham số phân phối xác suất của văn bản p(d).
- Số lượng tham số của mô hình tăng tuyến tính với số lượng văn bản. Do đó, mô hình không hoạt động tốt với dữ liệu lớn.
Chính vì thế mô hình LDA được phát triển dựa trên mô hình pLSA nhằm khắc phục những khuyết điểm trên. LDA về cơ bản cũng là một mô hình được phát triển dựa trên pLSA nhưng phân phối xác suất của dựa trên hàm Dirichlet nên được gọi là
Latent Dirichlet Allocation. Trong lớp những bài toán phân loại chủ đề thì thuật toán LDA là một trong những lớp mô hình được ưa chuộng vì hiệu quả tính toán nhanh, đưa ra kết quả chính xác dựa trên lớp mô hình sinh. Kết quả của LDA trả ra bao gồm phân phối theo văn bản và phân phối theo mỗi từ. Trong đó phân phối theo văn bản là một tập hợp phân phối hỗn hợp của một số lượng cố định các chủ đề và mỗi từ sẽ biểu diễn mức độ đóng góp vào văn bản thông qua biểu diễn của nó theo chủ đề (Phạm Đình Khánh, 2019).
Mô hình Latent Dirichlet Allocation (LDA)
 Trong học máy và xử lý ngôn ngữ tự nhiên, mô hình chủ đề là một mô hình thống kê để khám phá các cấu trúc ngữ nghĩa ẩn, các “chủ đề” xảy ra trong tập ngữ liệu. Mô hình LDA là một mô hình xác suất nhằm khám phá ra các chủ đề ẩn từ tập ngữ liệu (Blei và cộng sự, 2003). Kết quả của LDA bao gồm phân phối xác suất theo văn bản và phân phối xác suất theo từ.
Hình 3.3: Mô hình LDA (Blei và cộng sự, 2003)
Các định nghĩa và ký hiệu sử dụng trong mô hình sinh xác suất ở Hình 3.3 được tác giả tổng hợp và mô tả trong Bảng 3.1 dưới đây.
F:\DỮ LIỆU MỚI CẦN ĐỔI TÊN VÀ ĐĂNG 2025\ĐÃ HOÀN THÀNH 2024\LUẬN VĂN THẠC SĨ CÁC ĐẠI HỌC KHÁC\KHO SỐ 1\BÁO CÁO KẾT QUẢ THỰC TẬP VÀ GIẢI PHÁP NÂNG CAO CHẤT LƯỢNG ĐỘI NGŨ LAO ĐỘNG TẠI BỘ PHẬN LỄ TÂB KHÁCH SẠN ADALINE\THAM KHẢO/ THAM KHẢO CHUẨN 01