Nghiên cứu DeConverter để dịch tự động từ UNL sang tiếng Việt
Trong thời đại công nghệ thông tin với sự phát triển nhanh và đạt được nhiều thành tựu to lớn trong các lĩnh vực kinh tế, kỹ thuật, văn hoá, xã hội,… Cùng với sự phát triển này, nhân loại đã tạo ra lượng thông tin khổng lồ và phần lớn những thông tin đó chúng ta có thể tìm thấy thông qua hệ thống mạng Internet. Tuy nhiên, lượng thông tin này con người vẫn chưa được khai thác hết bởi rất nhiều lý do, lý do quan trọng nhất dẫn đến việc hạn chế khai thác thông tin trên, đó là rào cản ngôn ngữ vì nhiều con người chỉ biết mỗi ngôn ngữ mẹ đẻ hoặc biết một trong số những ngôn ngữ phổ biến như tiếng Anh, tiếng Pháp, tiếng Tây Ban Nha, tiếng Trung Quốc. Với sự phát triển của công nghệ thông tin giải pháp nhằm phá bỏ rào cản ngôn ngữ là phát triển các hệ thống dịch tự động.
Nhiều nghiên cứu về dịch tự động đã tạo những công cụ dịch hiệu quả và được sử dụng phổ biến như Google, AltaVisa,… Có những hệ thống thương mại hoá như Systran, Reverso, Babylon, … Những hệ thống này cho phép tạo ra “bản dịch nghĩa” – một bản dịch chưa được hoàn chỉnh nhưng giúp chúng ta có thể hiểu được ý nghĩa của văn bản gốc và cần phải chỉnh sửa nhiều để trở thành một văn bản hoàn chỉnh. Các hệ thống dịch tự động cho phép dịch rất nhanh và chi phí thấp hơn nhiều so với dịch bằng con người. Tuy nhiên, những hệ thống này đang phải đối mặt với rất nhiều vấn đề như sự đa nghĩa của từ, sự nhập nhằng về ngữ nghĩa, sự phụ thuộc về ngữ cảnh và nhiều khó khăn về sự khác biệt nhằm giải thích các khái niệm.
Hiện nay, nhu cầu về các hệ thống xử lý ngôn ngữ tự nhiên ngày càng tăng vì nó cần được ứng dụng trong nhiều lĩnh vực vì vậy vấn đề xử lý ngôn ngữ tự nhiên hiện nay rất cần các tài liệu song ngữ hoặc đa ngữ, cho nên phát triển các hệ thống xử lý ngôn ngữ tự nhiên dựa trên các kho ngữ liệu đang được nghiên cứu và triển khai ngày càng nhiều.
Hiện nay, dịch tự động góp phần quan trọng trong quá trình phát triển kinh tế và xã hội của các quốc gia bởi nó xóa bỏ rào cản về ngôn ngữ. Trên thế giới có nhiều kho ngữ liệu song ngữ như Anh – Pháp, Anh – Hoa,… song việc nghiên cứu và phát triển các ứng dụng để dịch tự động từ UNL sang tiếng Việt còn hạn chế. Được sự gợi ý của PGS.TS Võ Trung Hùng tôi chọn đề tài “Nghiên cứu DeConverter để dịch tự động từ UNL sang tiếng Việt” làm đề tài tốt nghiệp luận văn cao học.
Mục đích của đề tài tìm hiểu và trình bày tổng quan về dịch tự động, các phương pháp dịch trên cơ sở đó nghiên cứu hệ thống DeConverter để dịch tự động từ UNL sang tiếng Việt phục vụ việc xử lý ngôn ngữ tự nhiên liên quan đến tiếng Việt.
Nhiệm vụ cụ thể là nghiên cứu về ngôn ngữ UNL; nghiên cứu quá trình thực hiện chuyển đổi từ ngôn ngữ UNL sang ngôn ngữ tự nhiên – Tiếng Việt thông qua hai phần mềm DeCo và Eugene; sau khi thử nghiệm, đánh giá và đề xuất giải pháp ứng dụng các công cụ phát triển của UNL cho tiếng Việt. Kết quả nay sẽ tạo tiền đề cho việc nhanh chóng xây dựng thành công hệ thống dịch tự động đa nghĩa cho tiếng Việt trong tương lai.
Chúng tôi tập trung nghiên cứu về hệ thống UNL và tìm hiểu về dịch tự động, các phương pháp dịch tự động. Ngoài ra, nghiên cứu về kho ngữ liệu (linguistics corpus) và kho ngữ liệu đa ngữ (multilingual linguistics corpus).
Nghiên cứu sâu về hệ thống DeConverter trong UNL và các công cụ của nó như DeCo, Eugene.
Đề tài đề xuất giải pháp và thực nghiệm các công cụ dịch tự động sẵn có để dịch tự động các biểu thức UNL sang tiếng Việt từ các kho ngữ liệu sẵn có.
Trong khuân khổ của một luận văn thực nghiệm chúng tôi tập trung nghiên cứu hệ thống UNL: Ngôn ngữ UNL và mô hình hoạt động của hệ thống dịch UNL, kho ngữ liệu (Linguistics Corpus), các mô hình triển khai hệ thống và nghiên cứu kỹ các công cụ DeCoverter: Eugene, DeCo để thực nghiệm dịch các biểu thức UNL sang tiếng Việt. Ngoài ra, chúng tôi cũng giới thiệu tổng quát các hệ thống dịch hiện nay trên Internet như Systran, Google, Reverso,… trên cơ sở một số bài báo và luận văn tốt nghiệp khóa trước.
Phương pháp nghiên cứu, chúng tôi đã sử dụng hai phương pháp chính là nghiên cứu lý thuyết và nghiên cứu thực nghiệm. Với phương pháp nghiên cứu lý thuyết chúng tôi tiến hành thu thập các tài liệu về cơ sở lý thuyết: Hệ thống UNL – DeConverter, dịch tự động, các tài liệu mô tả một số công cụ DeConverter và các tài liệu liên quan đến vấn đề nghiên cứu.
Đối với phương pháp thực nghiệm chúng tôi nghiên cứu sử dụng các công cụ của DeConverter để dịch các kho ngữ liệu sẵn có sang ngôn ngữ tiếng Việt, sau đó thực nghiệm dịch và kiểm tra một số biểu thức UNL sang tiếng Việt.
Bố cục của của luận văn được tổ chức thành 3 chương chính như sau:
Chương 1. Tổng quan về dịch tự động và UNL
Chương 2. UNL DeConverter và các công cụ
Chương 3. Thử nghiệm dịch biểu thức UNL sang tiếng Việt bằng các công cụ của DeConverter
Kết luận và hướng phát triển của đề tài.

CHƯƠNG 1
TỔNG QUAN VỀ DỊCH TỰ ĐỘNG VÀ UNL
Trong chương này, chúng tôi giới thiệu về lịch sử phát triển của dịch tự động, sau đó trình bày tổng quan về ngôn ngữ UNL và trình bày chi tiết quá trình mã hóa (EnConverter) và giải mã (DeCoverter) trong hệ thống UNL.
1.1. GIỚI THIỆU VỀ DỊCH TỰ ĐỘNG
1.1.1. Khái niệm
Dịch tự động hay còn gọi là dịch máy (MT: Machine Translation) là một nhánh của xử lý ngôn ngữ tự nhiên thuộc phân ngành trí tuệ nhân tạo, nó là sự kết hợp giữa ngôn ngữ, dịch thuật và khoa học máy tính. Dịch tự động thực hiện dịch một ngôn ngữ này sang một hoặc nhiều ngôn ngữ khác một cách tự động, có hoặc không có sự trợ giúp của con người [15].
Thuật ngữ dịch máy hay dịch tự động không chỉ bao gồm máy tính dựa vào các bộ từ điển và các phương pháp tiếp cận vào cơ sở dữ liệu để có thể đọc được văn bản hoặc tương tác với quá trình xử lý ngôn ngữ, chỉnh sửa văn bản để cho ra bản dịch cuối cùng, trường hợp bản dịch tự động hoàn toàn do máy tính không có sự can thiệp của con người có thể được hiểu như một “bản dịch nghĩa”. Dịch tự động bằng máy tính nó không phải là lĩnh vực độc lập, mà nó là được kết hợp bởi các ngành khoa học khác để phát triển hoàn thiện.
1.1.2. Lịch sử phát triển
Những năm 50 thế kỉ XX, các nhóm nghiên cứu ở Hoa Kì và Châu Âu đã tập trung vào lĩnh vực dịch tự động dưới sự bảo trợ của chính phủ và các nhà đầu tư. Đã có ít nhất ba hệ thống dịch tự động được nhiều tổ chức khoa học và quân sự thường xuyên sử dụng.
Những năm 60 thế kỉ XX, dịch tự động đã được nghiên cứu và thực hiện ở Hoa Kì, Canada và Châu Âu như Đại học Brigham Young (Hoa Kì) với hệ thống METEO, các nhóm GENA và SUSY (Châu Âu). Cuối những năm 70 thế kỉ XX, cùng với sự phát triển của kĩ thuật số, dịch tự động chuyển sang giai đoạn phát triển mới: dịch tự động được nghiên cứu và thực hiện với sự tham gia của con người vào các quá trình dịch của máy. Những năm 90, đã đánh dấu sự phát triển mạnh mẽ của công nghệ thông tin và kĩ thuật số trong nhiều lĩnh vực kinh tế và xã hội.
Hiện nay, nhiều sản phẩm dịch tự động đã và đang được sử dụng như các hệ thống dịch tự động với tốc độ dịch rất nhanh và độ chính xác khá cao. Dịch tự động (dịch bằng máy) được coi là mấu chốt trong các vấn đề kinh tế và xã hội của các quốc gia thời đại giao tiếp thông tin quốc tế.
1.1.3. Vấn đề dịch tự động cho tiếng Việt
Dịch tự động từ tiếng nước ngoài sang tiếng Việt được bắt đầu vào những năm 60. Tháng 6 năm 1970 hệ thống dịch tự động Logos I ra đời với từ điển tự động hóa hỗ trợ chỉ bao gồm hơn 1000 từ tiếng Việt. Năm 70 thế kỉ XX, hệ thống dịch tự động từ tiếng Anh ra tiếng Việt đã được tiến hành tại Tập đoàn viễn thông Xyzyx, California. Nhờ các hệ thống này, hiệu quả lao động của người dịch và chất lượng của cán bộ chuyên ngành được nâng cao. Việc dịch các đoạn văn dài, có nhiều từ chuyên ngành và phụ thuộc vào ngữ cảch thì độ chính xác chưa cao.
Systran là một hệ thống dịch tự động rất nổi tiếng và có chất lượng dịch khá tốt được sử dụng trên môi trường Internet, có thể dịch được cho 52 cặp ngôn ngữ.
Đây là hệ thống dịch tự động của Softissimo để dịch các văn bản hoặc các trang Web với định dạng HTML, có thể thực hiện dựa trên Internet, Intranet hoặc như là một ứng dụng trên máy đơn.
WorldLingo là một công cụ dịch thuật miễn phí, nó có thể dịch một đoạn văn bản hay cả trang web. WorldLingo được kiểm nghiệm có độ chính xác dịch thuật lên đến 75%.
Google Translate không chỉ mạnh ở khả năng dịch chuẩn, dịch sát ý, nó còn hỗ trợ nhiều ngôn ngữ, trong đó có tiếng Việt. Chức năng chính của Google Translate là dịch một câu, đoạn văn bản hoặc cả trang web sang ngôn ngữ yêu cầu. Google Translate sử dụng phần mềm dịch thuật riêng có chất lượng tốt, tuy nhiên nó chưa phải là công cụ dịch thuật hoàn hảo.
1.3. TỔNG QUAN VỀ NGÔN NGỮ UNL
UNL là từ viết tắt của “Universal Networking Language”. Nó là ngôn ngữ máy tính cho phép máy tính có thể truy cập thông tin và tri thức mà không bị vấn đề về rào cản ngôn ngữ. Nó là một ngôn ngữ giả có khả năng mô phỏng thế giới ngôn ngữ tự nhiên của con người trong giao tiếp. UNL biểu diễn thông tin hoặc tri thức dưới dạng mạng ngữ nghĩa với cấu trúc đa đồ thị. Sự biểu diễn của UNL là không nhập nhằng. Trong mạng đa ngữ nghĩa của UNL, nút biểu diễn khái niệm và cạnh biểu diễn mối quan hệ giữa các khái niệm.
UNL bao gồm các thành phần của ngôn ngữ tự nhiên. UNL bao gồm Universal Word (UW) – từ vựng, Relation – Quan hệ, Attributes – Thuộc tính và UNL Knowledge Base – Cơ sở tri thức. Nó tạo ra các từ biểu diễn các khái niệm gọi là “Universal Word” gọi tắt là UW, UW chứa các từ vựng của UNL. Nó liên kết các từ vựng khác tạo thành câu. Những liên kết này gọi là “relation” – mối quan hệ, nó chỉ định vai trò của mỗi từ trong câu. Ngụ ý của người nói có thể được diễn tả thông qua “Attribute” – Thuộc tính.
“UNLKB” cung cấp định nghĩa về ngữ nghĩa của từ vựng. UNLKB định nghĩa quan hệ có thể có giữa các khái niệm, bao gồm các quan hệ phân cấp và kỹ thuật tham chiếu giữa các khái niệm, nghĩa của biểu thức UNL là không nhập nhằng. [10]
UNL có thể giảm chi phí phát triển tri thức và những khái niệm cần thiết cho quá trình xử lý tri thức bằng cách chia sẻ tri thức và khái niệm. Câu thông tin được biểu diễn thành đa đồ thị gồm có từ vựng (Universal Word – UW) gọi là nút và các quan hệ gọi là cạnh. Đa đồ thị này cũng được biểu diễn như là tập quan hệ nhị phân có hướng, mỗi quan hệ nhị phân chỉ mỗi quan hệ giữa hai từ vựng được biểu diễn trong câu. UNL biểu diễn thông tin phân thành chủ ngữ và vị ngữ. Chủ ngữ được biểu diễn sử dụng từ vựng và quan hệ. Vị ngữ được biểu diễn sử dụng thuộc tính được gắn kèm với từ vựng.
UNL biểu diễn thông tin và tri thức theo hình thái mạng ngữ nghĩa với đa đồ thị. Mạng ngữ nghĩa UNL là một tập các quan hệ nhị phân, mỗi quan hệ nhị phân bao gồm một quan hệ và hai từ vựng của mối quan hệ đó. Mối quan hệ nhị phân của UNL được biểu diễn theo dạng sau:
<relation>(<uw1>,<uw2>)
<relation> là một trong các quan hệ được miêu tả trong UNL Specifications.
<uw1>, <uw2> là hai từ vựng chứa trong mối quan hệ <relation>.
Đa đồ thị: Biểu thức UNL là mạng đa ngữ nghĩa. Một nút bao gồm mạng ngữ nghĩa của biểu thức UNL được gọi là “scope”. Miêu tả dạng chung của quan hệ nhị phân của biểu thức UNL như sau:
<relation>:<scope-id> (<node1>,<node2>)
Ví dụ 1: Ta có câu tiếng Anh: “Anh works from Monday to Friday”
Được biểu diễn trong UNL như sau:
agt(work(icl>do).@entry.@present,Anh(iof>person)) ma(work(icl>do).@entry.@present,Monday) fmt(Monday,Friday)
Được biểu diễn trong đa đồ thị như sau:
agt
ma
fmt
- Hình 1.7. Biểu diễn đồ thị của ví dụ 1
Quan hệ của UNL được lựa chọn dựa theo các tiên đề sau:
Tiên đề 1: Điều kiện cần
Khi một từ vựng có quan hệ với nhiều hơn một từ vựng khác, mỗi quan hệ nên được gán nhãn và do đó có thể phân biệt các quan hệ là điều kiện cần cho các khái niệm của mỗi biểu diễn UW.
Tiên đề 2: Điều kiện đủ
Khi có các quan hệ giữa các từ vựng thì nhãn quan hệ nên được gán làm sao để có thể hiện được vai trò của mỗi từ vựng.
Nhãn quan hệ được biểu diễn tối đa bởi chuỗi gồm ba ký tự. Quan hệ giữa các từ vựng là quan hệ nhị phân, các quan hệ có nhãn khác nhau dựa theo vai trò khác nhau mà chúng thể hiện.
1.3.3. Từ vựng UNL
Một từ vựng UNL không chỉ là một đơn vị cú pháp và ngữ nghĩa của UNL để diễn tả khái niệm, diễn tả một câu hoặc một khái niệm phức tạp. Từ vựng UNL được biểu diễn bằng một nút trong đa đồ thị của biểu thức UNL.
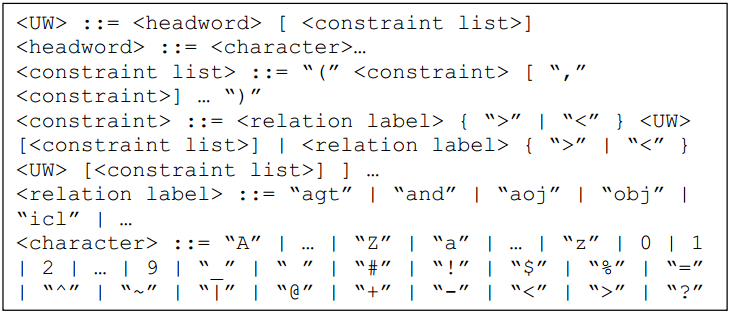
Cấu trúc UNL: Một UW là một chuỗi các ký tự với các ràng buộc, gồm: Headword – Từ mục; Constraints or Retrictions – Ràng buộc…
Từ vựng là chuỗi ký tự, miêu tả các mức khái niệm khác nhau phụ thuộc vào các ràng buộc và có thể sử dụng để miêu tả các khái niệm đặc biệt, riêng biệt hơn, cụ thể hơn bằng cách đưa các thuộc tính và ID hoặc sự ràng buộc từ các miêu tả UNL khác. Có 4 loại từ vựng như sau:
Từ vựng cơ bản; Từ vựng ràng buộc; Từ vựng mở rộng; Từ vựng tạm thời.
Cách để trích dẫn từ vựng phức hợp
Được định nghĩa một lần, một từ vựng phức hợp có thể được trích dẫn hoặc tham chiếu đến bằng một cách đơn giản nhất là sử dụng ID của từ vựng phức hợp như là một từ vựng.
1.3.4. Thuộc tính từ vựng UNL
Thuộc tính của từ vựng được dùng để miêu tả chủ ngữ của câu. Nó cho thấy quan điểm và diễn đạt quan điểm của người nói.
Một hệ thống UNL cơ bản bao gồm: UNL Language Servers, UNL Editor, UNL Viewer.
Khi một người bất kỳ truy cập vào Internet, người dùng có thể “mã hoá” (EnCoverter) văn bản được viết bằng ngôn ngữ của mình sang UNL. Tương tự, UNL bất kỳ có thể được “giải mã” (DeConverter) sang ngôn ngữ tự nhiên khác nhau. Quá trình xử lý “giải mã” và “mã hoá” được cung cấp bởi Languager Server được đặt trên mạng Internet. “Mã hoá” và “giải mã” có nhiệm vụ chuyển đổi một ngôn ngữ tự nhiên riêng biệt sang UNL và ngược lại.
Quá trình mã hoá (EnConverter) là phần mềm chuyển đổi một cách tự động văn bản từ ngôn ngữ tự nhiên sang UNL. Quá trình mã hoá làm việc theo cách sau: Chuỗi đầu vào sẽ được duyệt từ trái sang phải. Sau khi chuỗi đầu vào đã được duyệt xong, tất cả các hình vị được đánh dấu với các ký tự bắt đầu tương ứng trong từ điển và trở thành các hình vị thích hợp.
1.4.2. Quá trình DeConverter trong hệ thống dịch
Quá trình giải mã (DeConverter) được thể hiện trong hệ thống dịch tự động được minh họa như sau:
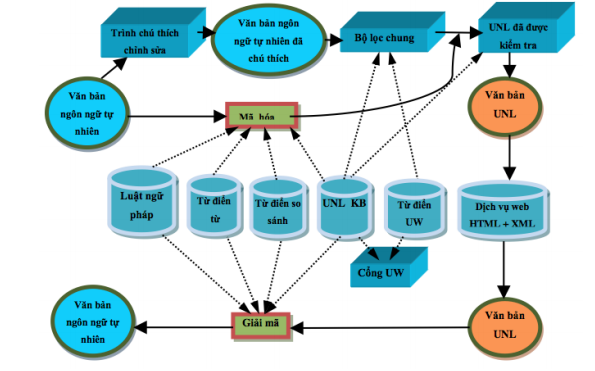
Hình 1.16. Quá trình DeConverter trong hệ thống UNL
Từ điển là các từ lưu thông tin về ngôn ngữ, thông tin có liên quan đến loại của từ vựng, ngôn ngữ biểu diễn và nơi mà từ này có thể được sử dụng. Từ điển từ chứa các thành phần sau: UW cho định nghĩa khái niệm; Tiêu đề của từ để biểu diễn khái niệm; Thông tin về hoạt động cú pháp của từ.
CHƯƠNG 2
UNL DECONVERTER VÀ CÁC CÔNG CỤ
Trong chương này, chúng tôi giới thiệu tổng quan về DeConverter trong hệ thống UNL và các công cụ để DeConverter.
“DeConverter” là thành phần quan trọng trong hệ thống UNL, nó là phần mềm tự động giải mã UNL sang ngôn ngữ tự nhiên cho chất lượng dịch cao, kết quả chính xác. Nó là thành phần quan trọng là kiến trúc cơ bản của “DeConverter” để xử lý được tất cả các ngôn ngữ với chất lượng và độ chính xác ở cùng một tiêu chuẩn. Công nghệ phát triển cho ngôn ngữ này có thể được áp dụng cho các ngôn ngữ khác miễn là các kiến trúc được chia sẻ. DeConverter dịch ra ngôn ngữ tự nhiên từ UNL, đóng vai trò nòng cốt trong hệ thống UNL.
Để có thể chuyển biểu thức UNL ra các ngôn ngữ tự nhiên khác chương trình cần sử dụng một số dữ liệu ngôn ngữ như từ điển, các luật về ngữ pháp và từ điển đồng nghĩa. Quá trình giải mã áp dụng các luật tổng quát chung cho từng nút trong Node – net và sinh ra danh sách từ trong ngôn ngữ đích. Quá trình giải mã là khả năng phát sinh tương tự như máy turing. Nó có khả năng phát sinh tất cả các loại câu, thích hợp đối với cả các loại ngôn ngữ. [14]
F:\DỮ LIỆU COP CỦA CHỊ YẾN\DAI HOC DA NANG\KHOA HOC MAY TINH\LUONG DUY BAO