
Xây dựng mô hình dự báo lưu lượng nước về hồ thủy điện A Lưới dựa trên thuật toán máy học
Biến đổi khí hậu đã có nhiều ảnh hưởng tác động đến sự thay đổi lưu lượng tại các vùng, lưu vực trên thế giới nói chung và Việt Nam nói riêng, trong đó lượng mưa có ảnh hưởng trực tiếp đến diễn biến dòng chảy, tác động tới công tác quản lý vận hành hồ chứa trên cả nước, đây là một thách thức ngày càng lớn trong điều kiện biến đổi khí hậu, đòi hỏi cần phải giải quyết bài toán về dự báo trước lưu lượng đến hồ để xây dựng quy trình vận hành hồ hợp lý có ý nghĩa rất quan trọng trong công tác quản lý vận hành hệ thống hồ chứa thủy lợi nói chung và vận hành hồ chứa thủy điện nói riêng trong việc phát điện.
Do nhiều yếu tố ảnh hưởng và sự biến đổi rất lớn của thiên nhiên, dự báo dòng chảy là một bài toán phức tạp, khối lượng tính toán lớn và cần nhiều thông số đầu vào. Vì vậy, các nhà quản lý vận hành luôn nghiên cứu cải tiến các phương pháp để đưa ra phương pháp dự báo mới hạn chế lệ thuộc nhiều yêu tố đầu vào để tính toán.
Tại Việt Nam, một số mô hình dự báo đã được đưa vào áp dụng như ETA, RAMS, WRF. Mỗi mô hình đều có các sai số sinh ra do số liệu ban đầu, do quá trình tham số hóa chưa chuẩn xác. Do đó trước khi áp dụng một mô hình cần phải phân tích được những ưu nhược điểm để khai thác và khắc phục, mang lại hiệu quả cao cho công tác dự báo.
Xây dựng mô hình dự báo lưu lượng nước về hồ chứa dựa trên thuật toán máy học là một hướng đi mới sẽ có nhiều ưu điểm vì nó là một mô hình tính toán mô phỏng hoạt động của não người. Đây là mô hình có tính mềm dẻo, chấp nhận thông tin không chính xác, dễ thích nghi, làm giảm đáng kể độ phức tạp và thời gian tính toán.
Luận văn này sẽ xây dựng mô hình dự báo lưu lượng nước về Hồ thủy điện A Lưới, tỉnh Thừa Thiên Huế dựa trên thuật toán máy học, xác định các thông số hợp lý của mạng, các thông số huấn luyện mạng theo thuật toán lan truyền ngược bằng thực nghiệm, trên cơ sở đó lập hệ dự báo để dự báo một cách nhanh chóng sự biến đổi của các số thông số khí tượng.
Xuất phát từ những lý do trên, tác giả kiến nghị lựa chọn đề tài: “Xây dựng mô hình dự báo lưu lượng nước về hồ thủy điện A Lưới dựa trên thuật toán máy học” để nghiên cứu.
Nghiên cứu ứng dụng các thuật toán máy học để xây dựng mô hình dự báo lưu lượng về hồ thủy điện A Lưới, huyện A Lưới, tỉnh TT Huế.
3. ĐỐI TƯỢNG VÀ PHẠM VI NGHIÊN CỨU
- Đối tượng nghiên cứu: Lưu lượng nước về hồ thủy điện A Lưới.
- Phạm vi nghiên cứu: Hồ chứa công trình thủy điện A Lưới, huyện A Lưới, tỉnh Thừa Thiên Huế.
- Thu thập tài liệu thủy văn về lượng mưa và lưu lượng nước về trên lưu vực hồ chứa công trình thủy điện A Lưới;
- Nghiên cứu cơ sở lý thuyết của các thuật toán máy học để xây dựng mô hình dự báo lưu lượng nước đến hồ thủy điện A Lưới, tỉnh Thừa Thiên Huế.
- Nghiên cứu tổng quan về các phương pháp dự báo.
- Phương pháp phân tích dữ liệu: Thu thập, đánh giá dữ liệu lưu lượng nước về hồ thủy điện A Lưới theo các tháng trong năm. Bao gồm: chuỗi dữ liệu lưu lượng nước về hồ, lượng mưa giai đoạn lập thiết kế dự án (31 năm) và chuỗi dữ liệu lưu lượng về hồ, lượng mưa giai đoạn vận hành (12 năm).
- Phương pháp xây dựng mô hình: Ứng dụng các thuật toán máy học để xây dựng mô hình dự báo (Prediction model) lưu lượng nước về hồ thủy điện A Lưới dựa trên các mô hình trí tuệ nhân tạo như support vector machine, artficial neural network, evolutionary multivariate regression…
6. Ý NGHĨA KHOA HỌC VÀ THỰC TIỄN
Kết quả nghiên cứu sẽ cung cấp thêm một phương pháp mới dựa trên các thuật toán máy học để xây dựng mô hình dự báo lưu lượng nước về hồ chứa. Qua đó giúp cho Chủ đầu tư Nhà máy thủy điện chủ động trong công tác quản lý vận hành hồ chứa, điều tiết nước hợp lý phát điện và chủ động hơn trong việc xây dựng kế hoạch sản xuất điện hằng năm.
CHƯƠNG 1
TỔNG QUAN VỀ PHƯƠNG PHÁP NGHIÊN CỨU
1.1. Các phương pháp nghiên cứu dự báo lưu lượng nước hiện nay
Trong thời kỳ đầu (khoảng năm 1960-1975), các phương pháp dự báo mưa-dòng chảy chủ yếu dựa trên các phân tích diễn biến lịch sử, đường cong lũy tích chu kỳ nguồn nước, phân tích xu thế. Từ năm 1975, công tác dự báo đã có nhiều bước tiến mới, ứng dụng các kỹ thuật máy tính phát triển các phương trình đơn lẻ phân tích thống kê các phương trình hồi quy tương quan dòng chảy với mưa và với các đặc trưng dòng chảy theo thời gian…Trong giai đoạn này, Sử dụng một số phương pháp dự báo biến động dòng chảy như:
- Mô hình thống kê đa biến,
- Mô hình nhận dạng,
- Sử dụng hàm điều hòa,
- Phân tích chuỗi thời gian như mô hình ARIMA,
- Mô hình mạng thần kinh nhân tạo ANN…lập tương quan dòng chảy với dự báo dòng chảy tháng trong cả mùa lũ và mùa cạn đã được sử dụng trên các lưu vực sông.
1.2. Tổng quan tình hình nghiên cứu thuộc lĩnh vực của đề tài ở trong và ngoài nước
1.2.1. Ứng dụng trí tuệ nhân tạo trong các lĩnh vực
1.2.2. Ứng dụng thuật toán máy học dự báo lưu lượng nước trên thế giới
1.2.3. Ứng dụng thuật toán máy học dự báo lưu lượng nước trong nước
Cho đến nay, trong các nghiên cứu về dự báo lưu lượng vào hồ chứa nói riêng, hay dự báo hoặc mô phỏng lưu lượng/quá trình mưa-dòng chảy đều sử dụng các mô hình thủy văn phân bố hay bán phân bố khác nhau. Các mô hình loại này dược xây dựng để mô phỏng đặc tính vật lý và quá trình của dòng chảy. Do khả năng mô phỏng có độ chính xác cao các quá trình vật lý và phân tích độ nhạy cảm một cách toàn diện, hơn nữa các mô hình này rất hữu ích cho các nhà khoa học trong việc giải thích được toàn bộ quá trình ẩn đẳng sau, do đó các mô hình loại này được áp dụng khá rộng rãi ở nhiều khu vực trên thế giới Tuy nhiên, việc sử dụng các mô hình này thường yêu cầu một lượng dữ liệu chi tiết về đặc tính của lưu vực như các số liệu thông tin địa lý, mưa, dòng chảy, địa chất… Bên cạnh nó việc hiệu chỉnh và kiểm định mô hình cũng rất phức tạp và đòi hỏi nhiều thời gian, kinh nghiệm và kiến thức của người chạy mô hình đối với từng lưu vực cụ thể. Vì vậy, khả năng áp dụng loại mô hình này ở nhiều khu vực và trong các bài toán dự báo thời đoạn ngắn vẫn còn bị hạn chế .
Những hạn chế của các mô hình truyền thống nêu trên đã khuyến khích sự phát triển của các mô hình dựa vào số liệu (data-driven models), mà phổ biến nhất gần đây có thể kể đến là phương pháp máy học (Machine Learning – ML). Các mô hình ML là công cụ tiềm năng trong việc dự báo dòng chảy do các mô hình này có thể được xây dựng dựa nhanh chóng, dễ dàng, không đòi hỏi phải có sự hiểu biết về các quá trình vật lý ẩn đằng sau. Ngoài ra, lượng dữ liệu yêu cầu tối thiểu, cùng với khả năng tính toán, hiệu chỉnh và kiểm định nhanh hơn so với các mô hình vật lý truyền thống, và cách sử dụng ít phức tạp hơn là những ưu điểm lớn mà các mô hình dựa vào số liệu mang lại.
Trong những năm qua, với sức mạnh cuộc cách mạng 4.0, trí tuệ nhân tạo đã được ứng dụng trong nhiều lĩnh vực hoạt động của doanh nghiệp và công tác quản lý. Với nội dung đề tài nghiên cứu đã có nhiều chủ đầu tư các nhà máy thủy điện, hồ chứa thủy lợi đã ứng dụng trí tuệ nhân tạo trong việc dự báo lưu lượng nước về hồ chứa, hữu ích trong công tác quản lý kế hoạch sản xuất kinh doạnh, an toàn hồ đập trong lưu vực sông, phục vụ phòng tránh giảm nhẹ thiên tai, cụ thể:
Nhà máy thủy điện Hòa Bình: Nghiên cứu phương pháp Deep learning để phân tích, dự báo trung hạn lưu lượng nước đổ về hồ Hòa Bình trước 10 ngày [49, 50], từ đó giúp hỗ trợ công tác ra quyết định trong điều hành hồ chứa. Các phương pháp học máy nổi tiếng khác như LASSO, cây hồi quy, K láng giềng, véc-tơ hỗ trợ hồi quy, rừng ngẫu nhiên đã được nghiên cứu, cài đặt thử nghiệm và so sánh với Deep learning để đánh giá hiệu năng của các mô hình dự báo. Kết quả thực nghiệm cho thấy phương pháp Deep learning cho kết quả dự báo tốt nhất với R2 đạt 92% và vượt trội so với các phương pháp khác khi so sánh dựa trên R2 và RMSE

Các hồ chứa trên lưu vực Sông Ba: Áp dụng mô hình trí tuệ nhân tạo và dự báo lưu lượng đến hồ lưu vực Sông Ba [1]. Trong nghiên cứu này, hai mô hình AI là Random Forest (RF) và Support Vector Machine (SVM/SVR) đã được áp dụng thử nghiệm đối với một hồ chứa lớn – hồ Sông Hinh trên lưu vực Sông Ba, Việt Nam. Ba trường hợp tính toán là dự báo lưu lượng trung bình 3 ngày, 7 ngày và 1 tháng (tương ứng với ngắn, trung và dài hạn) đến hồ sử dụng số liệu khí tượng, thủy văn trong khu vực đã được xây dựng để kiểm nghiệm khả năng dự báo của hai mô hình RF và SVR. Kết quả cho thấy, cả hai mô hình đều đưa ra kết quả dự báo với độ chính xác cao thể hiện qua chỉ số NSE trung bình đạt trên 0,8, đặc biệt trong một số trường hợp tính toán như dự báo lưu lượng trung hạn và dài hạn, chỉ số NSE trung bình trên 0,9.
Thủy điện Buôn Kuốp: Ứng dụng trí tuệ nhân tạo để dự báo lũ sớm. Với mục tiêu hoàn thiện hệ thống cảnh báo lũ, Công ty Thủy điện Buôn Kuốp [51] (Tổng công ty Phát điện 3) đã tích cực triển khai chuyển đổi số đối với hệ thống thu thập dữ liệu thủy văn, cảnh báo lũ và xây dựng bản đồ số vùng hạ du các nhà máy thủy điện Buôn Tua Srah, Buôn Kuốp, Srêpốk 3. những kỹ sư của Công ty Thủy điện Buôn Kuốp tự nghiên cứu và xây dựng. Dựa trên dữ liệu đã thu thập, các kỹ sư đã ứng dụng AI (trí tuệ nhân tạo) để phân tích, dự báo tình hình và cung cấp cảnh báo sớm. Đến nay, mô hình thu được những kết quả khá khả quan. Qua quá trình đối chiếu, so sánh với số liệu đo đạc và tình hình thực tế, mô hình dự báo lưu lượng về hồ Buôn Tua Srah hiện có độ chính xác khoảng 75% so với thực tế và trở thành một kênh hữu ích để công ty tham khảo. Đối với vùng hạ du, hệ thống cảnh bảo xả lũ của Công ty Thủy điện Buôn Kuốp đã vận hành từ năm 2009 và dần chuyển sang cảnh báo từ xa qua sóng điện thoại di dộng. Hiện 20 trạm cảnh báo đã bố trí dọc theo bờ sông vùng hạ du, đảm bảo các thông báo về tình hình chạy máy, thông báo điều tiết xả nước của nhà máy đến được với chính quyền và người dân trong vùng.
Hồ chứa nước Cửa Đạt, tỉnh Thanh Hóa có nhiệm vụ cấp nước tưới cho nông nghiệp và kết hợp phát điện, khi thiết kế chưa đề cập đến yếu tố biến đổi khí hậu nên những năm gần đây biến đổi khí hậu đã ảnh hưởng xấu đến việc vận hành hồ chứa. Bên cạnh đó, theo đà phát triển của xã hội thì nhu cầu nước sẽ thay đổi, theo xu hướng tăng, dẫn đến sự thay đổi trong vận hành, phân phối nước. Vì vậy, yêu cầu đặt ra là cần dự báo được lượng nước đến hồ phục vụ cho việc vận hành, phân phối nước an toàn và hiệu quả [2]. Kết quả dự báo lưu lượng nước đến hồ chứa Cửa Đạt trên cơ sở ứng dụng mạng thần kinh nhân tạo truyền thẳng nhiều lớp (ANN) sử dụng thuật toán lan truyền ngược đã đem lại một hướng đi mới trong công tác dự báo. Nghiên cứu này là ứng dụng mạng thần kinh nhân tạo truyền thẳng nhiều lớp (ANN) sử dụng thuật toán lan truyền ngược để dự báo lưu lượng nước đến hồ chứa Cửa Đạt trước 3 ngày trên cơ sở phân tích, đánh giá hai kịch bản: (1) Dự báo lưu lượng đến hồ chỉ xét đến yếu tố lưu lượng dòng chảy và (2) xét đến yếu tố lưu lượng dòng chảy và yếu tố lượng mưa. Kết quả cho thấy, khi có xét thêm yếu tố lượng mưa cho độ chính xác cao hơn. Cụ thể, với dữ liệu của trạm Cửa Đạt, sai số quân phương RMSE giảm từ 75.04091 m3/s xuống còn 56.35318 m3/s và chỉ số xác định R2 nâng cao từ 0.68 lên 0.72, tương tự với trạm Cẩm Thủy, sai số RMSE cũng giảm xuống và chỉ số xác định R2 tăng lên. Kết quả nghiên cứu cung cấp một phương pháp hữu ích trong bài toán dự báo, đặc biệt có ý nghĩa trong công tác quản lý nguồn nước và góp phần quan trọng trong việc xây dựng các phương án quản lý vận hành hồ chứa được chủ động hơn.
CHƯƠNG 2
CƠ SỞ LÝ THUYẾT CƠ BẢN CÁC THUẬT TOÁN
2.1. Cơ sở lý thuyết các thuật toán máy học
2.1.1. Mô hình mạng nơ-ron nhân tạo (ANN)
2.1.2. Mô hình máy học vectơ hỗ trợ (Support Vector Machine Model)
2.1.3. Cây phân loại và hồi quy (CART TREE)
2.1.4. Tự động phát hiện tương tác Chi-squared (CHAID)
2.1.6. Thuật toán Machine Learning Hồi quy tuyến tính ( Ordinary Least Squares Regression)
2.1.7. Kết hợp nhiều phương pháp (Ensemble Methods)
2.2. Nguồn dữ liệu và các tham số đầu vào mô hình nghiên cứu
- Đặc điểm dữ liệu:
Bộ dữ liệu bao gồm lượng mưa X (mm) và lưu lượng nước về trên lưu vực hồ thủy điện A Lưới Q (m3/s). Bao gồm dữ liệu 02 giai đoạn:
- Chuỗi dữ liệu lưu lượng nước về hồ, lượng mưa giai đoạn lập thiết kế, thi công dự án (34 năm: từ năm 1977 đến 2011), dữ liệu X, Q giai đoạn này được tính toán chuyển đổi theo phương pháp lưu vực tương tự.
- chuỗi dữ liệu lưu lượng về hồ, lượng mưa giai đoạn vận hành (09 năm: từ năm 2012 đến 2020), dữ liệu X, Q giai đoạn này là giá trị thưc đo tại lưu vực hồ A Lưới trong quá trình vận hành khai thác hồ chứa.
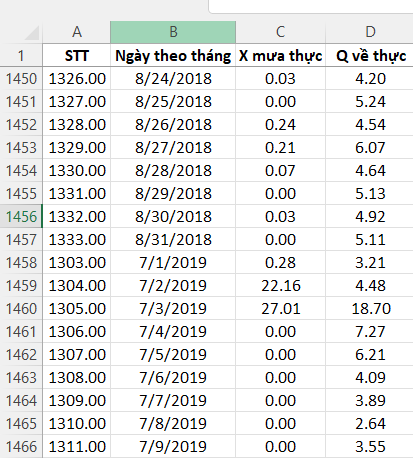
Dữ liệu sau khi xử lý được tổng hợp thành 01 file excel và dể dàng truy xuất mối quan hệ giữa lượng mưa ngày và lưu lượng nước về hồ ngày trong chuỗi dữ liệu quá khứ 43 năm.
Kết quả gom cụm và phân tích dữ liệu được lập quan hệ giữa lượng mưa và lưu lượng nước theo đơn vị ngày như bảng sau:
Bảng 2.1. Dữ liệu lượng mưa và lưu lượng nước quá khứ hồ thủy điện A Lưới cho phương án dự báo trước trung bình 03 và 07 ngày.
2.2.2. Tham số đầu vào mô hình
Dữ liệu TH1: Dự báo lưu lượng nước về hồ trung bình trước 03 ngày cho bộ dữ liệu từ tháng 7, tháng 8 trong chuỗi dữ liệu 43 năm: Dữ liệu huấn luyện gồm lượng mưa X và lưu lượng Q của tháng 7 (1977 đến 2020), tháng 8 (2012 đến 2020); Dữ liệu năm 2021 để dự báo thực tế đánh giá bộ thông số được tối ưu lựa chọn.
Bảng 2.2. Lựa chọn biến số dự báo lưu lượng nước về hồ trung bình trước 03 ngày
| Ký hiệu | Thuộc tính | Đơn vị | |
|---|---|---|---|
| Đầu vào X1 | Mưa trung bình 02 ngày hiện tại và sau liền kề | mm | (Xt+X(t-1))/2 |
| X2 | Mưa trung bình 03 ngày trước liền kề | mm | (X(t-1)+X(t-2)+X(t-3)/3 |
| X3 | Mưa trung bình 06 ngày trước liền kề | Mm | (X(t-1)+X(t-2)+…+X(t-6)/6 |
| X4` | Mưa ngày bình 03 ngày hiện tại và sau liền kề (Lấy từ nguồn Windy dự báo) | Mm | (Xt+X(t+1)+X(t+2)/3 |
| Q1 | Lưu lượng trung bình 02 ngày hiện tại và sau liền kề | m3/s | (Qt+Q(t-1))/2 |
| Q2 | Lưu lượng trung bình 03 ngày trước liền kề | m3/s | (Q(t-1)+Q(t-2)+Q(t-3)/3 |
| Q3 | Lưu lượng trung bình 06 ngày trước liền kề | m3/s | (Q(t-1)+Q(t-2)+…+Q(t-6)/6 |
| Q4 | Lưu lượng ngày dự báo | m3/s | Qday |
| Y+03day | Lưu lượng dự báo trung bình trước 3 ngày | m3/s | (Qday+Q(t+1)+Q(t+2))/3 |
Dữ liệu TH2: dự báo lưu lượng nước về hồ trung bình trước 07 ngày cho bộ dữ liệu từ tháng 7 đến tháng 8 trong chuỗi dữ liệu 43 năm: Dữ liệu huấn luyện gồm lượng mưa X và lưu lượng Q của tháng 7 (1977 đến 2020), tháng 8 (2012 đến 2020); Dữ liệu năm 2021 để kiểm tra bộ thông số được lựa chọn.
Bảng 2.3. Lựa chọn biến số dự báo lưu lượng nước về hồ trung bình trước 07 ngày
| Ký hiệu | Thuộc tính | Đơn vị | |
|---|---|---|---|
| Đầu vào X1 | Mưa ngày dự báo | mm | Xday |
| X2 | Mưa trung bình 07 ngày trước liền kề | mm | (X(t-1)+X(t-2)+..+X(t-7)/7 |
| X3 | Mưa trung bình 14 ngày trước liền kề | Mm | (X(t-1)+X(t-2)+…+X(t-14)/14 |
| X4` | Mưa ngày bình 07 ngày hiện tại và tương lai liền kề (lấy từ nguồn Windy dự báo) | Mm | (Xt+X(t+1)+…+X(t+6)/7 |
| Q1 | Lưu lượng ngày dự báo | m3/s | Qday |
| Q2 | Lưu lượng trung bình 07 ngày trước liền kề | m3/s | (Q(t-1)+Q(t-2)+..+Q(t-7)/7 |
| Q3 | Lưu lượng trung bình 14 ngày trước liền kề | m3/s | (Q(t-1)+Q(t-2)+…+Q(t-14)/14 |
| Q4 | Lưu lượng 02 ngày trước liền kề | m3/s | (Qt+Q(t-1))/2 |
| Y+07day | Lưu lượng dự báo trung bình trước 7 ngày | m3/s | (Qt+Q(t+1)+…+Q(t+6))/7 |
PHÂN TÍCH LỰA CHỌN THUẬT TOÁN MÁY HỌC ĐỂ XÂY DỰNG MÔ HÌNH DỰ BÁO LƯU LƯỢNG NƯỚC VỀ HỒ THỦY ĐIỆN A LƯỚI
3.1. Các thuật toán máy học trong đề tài nghiên cứu
Dự báo lưu lượng nước về hồ chứa trong thời gian ngắn hạn trung bình 03 ngày và trung bình 07 ngày có ý nghĩa rất quan trọng trong việc chủ động vận hành phát điện, cảnh báo lưu lượng lũ để vận hành xả tràn và tham gia đăng ký sản lượng điện phát trong thị trường điện cạnh tranh.
Mục tiêu chính của khái phá dữ liệu có được bằng cách kết hợp các phương pháp công nghệ của nhiều lĩnh vực khác nhau, bao gồm khoa học máy tính, thống kê, phân tích dữ liệu trực tuyến, máy học và các hệ thống chuyên gia [67]. Ứng dụng các thuật toán máy học ANN: Mạng Nơ ron thần kinh; SVM: náy hỗ trợ véc tơ; REGRESSION: Hồi quy tuyến tính; CHAID: tự động phát hiện tương tác Chi-Squared; C&R TREE: Phân hoại và hồi quy và các thuật toán kết hợp như đã trình bày ở chương 2 để dự báo lưu lượng nước về hồ chứa thủy điện A Lưới, tỉnh TT Huế trong các thời đoạn: trung bình 03 ngày và trung bình 07 ngày.
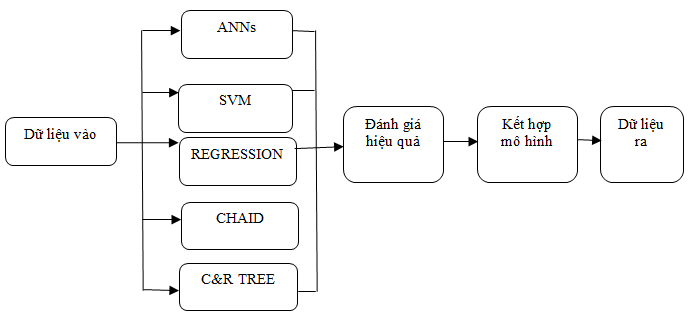
Hình 3.1. Sơ đồ khối mô hình dự báo lưu lượng nước đến hồ thủy điện A Lưới
Các thuật toán trên được sử dụng trong chương trình SPSS của IBM [68]. Năm 1965, Nilsson giới thiệu ý tưởng mô hình kết hợp cho các vấn đề phân loại dự liệu. Kỹ thuật mô hình tổng hợp, tổ hợp các điểm mạnh của mô hình riêng lẻ với mục đích tạo ra một mô hình dự báo tốt hơn. Bởi vì được kết hợp nhiều mô hình riêng lẻ sẽ tạo được mô hình dự báo mạnh và tính tổng quát cao. Nghiên cứu này sử dụng các kết quả thu được từ mô hình riêng lẻ tốt nhất sau đó được tổng hợp và xây dựng các mô hình kết hợp để dự báo lưu lượng nước đến hồ thủy điện A Lưới. Mô hình tổng hợp này sử dụng thuật toán logic chéo k-fold trên bộ dữ liệu đã được thu thập trước.
3.2. Các phương pháp đánh giá mô hình
3.2.1. Các chỉ tiêu đánh giá mô hình (Performance Measures)
Các phương pháp đo lường dưới đây được sử dụng để đánh giá độ chính xác của các mô hình dự đoán đề xuất:
- Hệ số tương quan tuyến tính (Linear Correlation Coefficient – R)
(14)
Trong đó là giá trị dự đoán; y là giá trị thực đo; và n số lượng điểm đo hay kích thước mẫu đo.
- Sai số phần trăm tuyệt đối trung bình (Mean Absolute Percentage Error – MAPE)
(15)
- Sai số tuyệt đối trung bình (Mean Absolute Error – MAE)
(16)
- Sai số bình phương trung bình (Root Mean Squared Error – RMSE)
(17)
Hơn nữa, để nhận được một đánh xếp hạng giá tổng hơn thì chỉ số tổng hợp (Synthesis Index – SIx) được sử dụng thông qua 4 đại lượng đo lường (1-R, MAPE, MAE, và RMSE), công thức của chỉ tiêu tổng hợp được trình bày như (18):
(18)
Trong đó, m = số lượng các chỉ tiêu đo lường; và Pi = chỉ tiêu đo lường thứ ith. Khoảng giá trị của SIx nằm trong khoảng 0–1; giá trị SIx tiến đến 0 biểu thị cho độ chính xác của mô hình dự đoán tốt hơn.
3.2.2. Thuật toán đánh giá chéo (Cross-fold Validation Algorithm)
Độ chính xác của hai hay nhiều mô hình thường được so sánh bởi thuật toán k-fold cross-validation nhằm tối thiểu hóa độ chệch liên quan đến việc chia dữ liệu trong quá trình huấn luyện mô hình. Nghiên cứu của Kohavi (1995) cho thấy rằng dữ liệu được chia thành 10 folds là tốt nhất [69].
Vì mục đích này, việc chia 10-fold được đề xuất để đảm bảo khả năng quát tổng hóa của mô hình. Toàn bộ dữ liệu được chia thành 10 tập con riêng biệt (subsets hoặc folds), một tập con được sử dụng để đánh giá mô hình, 9 tập con còn lại được sử dụng để huấn luyện mô hình (Hình 8). Cách thực hiện này được lặp 10 lần, vì thế tất cả 10 tập con đều được đánh giá. Kết quả cuối cùng nhận được là giá trị trung bình của 10 lần thực hiện [70] Các chỉ tiêu đánh giá kết quả của mô hình đề xuất là R, RMSE, MAE và MAPE. Giá trị R cao và các giá trị RMSE, MAE và MAPE thấp được xem như là những chỉ số báo hiệu kết quả của mô hình đề xuất tốt.
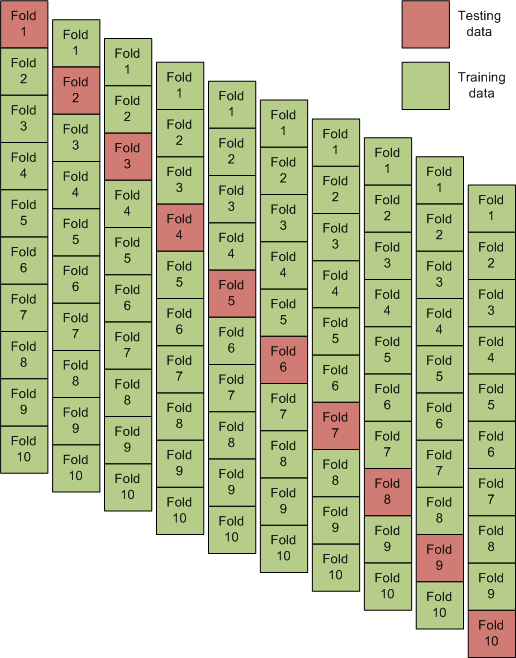
Hình 3.2. Phương pháp đánh giá chéo 10-fold.
3.3. Huấn luyện và kiểm định dữ liệu
3.3.1. Phương pháp khai phá dữ liệu
Thu thập dữ liệu lượng mưa ngày (Xmm) và lưu lượng nước trung bình ngày về hồ thủy điện A Lưới (Q m3/s) từ hồ sơ thiết kế công trình 1977-2011 và từ các năm vận hành nhà máy 2012 đến hết năm 2020; Lọc, làm sạch dữ liệu không phù hợp; Tính toán các biến đầu vào: Lượng mưa X1, X2, X3, X4; Lưu lượng nước Q1, Q2, Q3, Q4 theo các bảng 2,3,4 nêu trên; Lập file chạy dữ liệu, trong đó chia dữ liệu thành 10 fold gồm dữ liệu huấn luyện (training)và dữ liệu kiểm tra (testing).
- Sử dụng phần mềm Clementine 12 để khai phá dữ liệu [71]
- Nhánh training: Dữ liệu được huấn luyện theo 10 fold.
- Nhánh testing: Dữ liệu được kiểm tra lại, lựa chọn bộ thông số của 05 mô hình máy học: ANN (N); REGRESSION (E); SVM (S); C&R TREE (R); CHAID (R1).
3.3.3. Huấn luyện mô hình Fold 01 trường hợp dự báo trước 03 ngày:
- Khai phá dữ liệu cho các mô hình đơn:
- Khai phá dữ liệu cho các mô hình kết hợp:
Trình tự các bước thực hiện khai phá dữ liệu tìm ra các bộ thông số thuật toán nhánh training và testing như mục b nêu trên, riêng các thuật toán được kết hợp dựa trên các chỉ số đánh giá cao nhất và thực hiện các bước như hình sau:
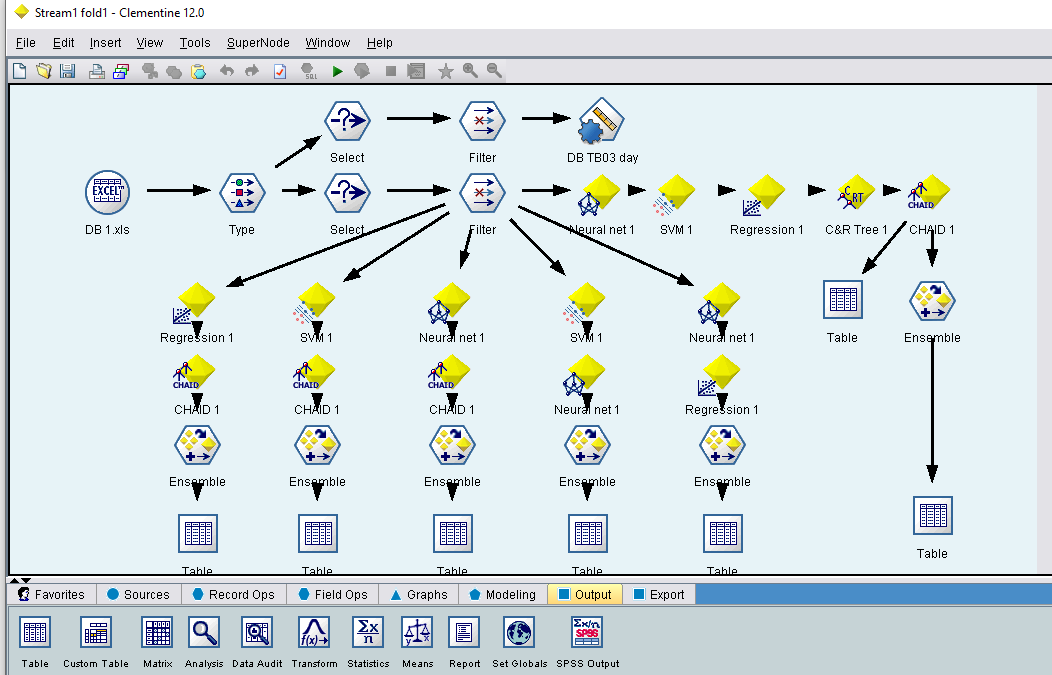
Hình 3.3. Các thuật toán phối hợp tổng thể
Các kết quả dự báo theo các thuật toán đơn và kết hợp này sẽ được lưu dữ liệu thành file excel để tính toán các chỉ số đánh giá lựa chọn mô hình tối ưu.
Việc thực hiện cho các fold còn lại được thực hiện tương tự như trên
3.3.4. Kết quả huấn luyện và kiểm định mô hình:
| Attributes | Unit | Minimum | Maximun | Average |
| X1 | mm | 0.00 | 98.10 | 5.30 |
| X2 | mm | 0.00 | 65.50 | 5.30 |
| X3 | mm | 0.00 | 37.17 | 5.32 |
| X4 | mm | 0.00 | 65.50 | 5.29 |
| Q1 | m3/s | 1.93 | 82.02 | 10.38 |
| Q2 | m3/s | 2.01 | 71.13 | 10.38 |
| Q3 | m3/s | 2.29 | 61.31 | 10.37 |
| Q4 | m3/s | 1.33 | 109.68 | 10.38 |
| Y+03day | m3/s | 2.01 | 71.13 | 10.38 |
Bảng 3.2. Tổng hợp tính toán hệ số tương quan các mô hình
| Performance measure | Predictive technique | Testing set | ||
| Best Accuracy | Average Accuracy | Best fold | ||
| R (%) Dataset 4 | N: NORON | 0.92 | 0.87 | 5 |
| S: SVM | 0.93 | 0.89 | 5 | |
| E: REGRES | 0.94 | 0.90 | 5 | |
| R: C&R TREE | 0.92 | 0.84 | 5 | |
| R1: CHAID1 | 0.90 | 0.84 | 3 | |
| N+E | 0.93 | 0.89 | 5 | |
| S+E | 0.93 | 0.89 | 5 | |
| N+R1 | 0.93 | 0.88 | 5 | |
| S-R1 | 0.93 | 0.88 | 5 | |
| E+R1 | 0.94 | 0.90 | 5 | |
Bảng 3.3. Tổng hợp kết quả tính toán chỉ số sai số căn quân phương RMSE
| Performance measure | Predictive technique | Testing set | ||
|---|---|---|---|---|
| Best Accuracy | Average Accuracy | Best fold | ||
| RMSE (m3/s) Dataset 1 | N: NORON | 2.67 | 3.85 | 7 |
| S: SVM | 2.15 | 3.59 | 3 | |
| E: REGRES | 2.33 | 3.10 | 10 | |
| R: C&R TREE | 2.83 | 3.90 | 3 | |
| R1: CHAID1 | 2.57 | 3.79 | 3 | |
| N+E | 2.55 | 3.28 | 3 | |
| S+E | 2.42 | 3.50 | 7 | |
| N+R1 | 2.44 | 3.49 | 7 | |
| S-R1 | 2.08 | 3.43 | 3 | |
| E+R1 | 2.26 | 3.13 | 3 | |
Bảng 3.4. Tổng hợp kết quả tính toán chỉ số sai số phần trăm tuyệt đối trung bình MAPE
| Performance measure | Predictive technique | Testing set | ||
| Best Accuracy | Average Accuracy | Best fold | ||
| MAPE (%) Dataset 2 | N: NORON | 0.18 | 0.29 | 1 |
| S: SVM | 0.18 | 0.21 | 1 | |
| E: REGRES | 0.15 | 0.17 | 1 | |
| R: C&R TREE | 0.17 | 0.19 | 5;6;9 | |
| R1: CHAID1 | 0.15 | 0.18 | 1 | |
| N+E | 0.16 | 0.22 | 1 | |
| S+E | 0.17 | 0.24 | 1 | |
| N+R1 | 0.14 | 0.21 | 1 | |
| S-R1 | 0.15 | 0.18 | 1 | |
| E+R1 | 0.14 | 0.16 | 1 | |
Bảng 3.5. Tổng hợp kết quả tính toán chỉ số sai số tuyệt đối trung bình MAE
| Performance measure | Predictive technique | Testing set | ||
| Best Accuracy | Average Accuracy | Best fold | ||
| MAE (M3/S) Dataset 3 | N: NORON | 1.89 | 2.64 | 7 |
| S: SVM | 1.68 | 2.09 | 3 | |
| E: REGRES | 1.51 | 1.78 | 10 | |
| R: C&R TREE | 1.79 | 2.09 | 3 | |
| R1: CHAID1 | 1.63 | 2.01 | 10 | |
| N+E | 1.75 | 2.07 | 3 | |
| S+E | 1.72 | 2.20 | 3 | |
| N+R1 | 1.60 | 2.10 | 3 | |
| S-R1 | 1.48 | 1.86 | 3 | |
| E+R1 | 1.43 | 1.73 | 10 | |
- Lựa chọn bộ thông số tối ưu: Bộ thông số tối ưu thỏa mãn các điều kiện R đạt max; RMSE, MAPE và MAE đạt min, cụ thể:
Bảng 3.6. Đánh xếp hạng giá tổng hơp theo chỉ số tổng hợp
| ` | N | S | E | R | R1 | N+E | S+E | N+R1 | S-R1 | E+R1 | Min | Max |
| R | 0.92 | 0.93 | 0.94 | 0.92 | 0.90 | 0.93 | 0.93 | 0.93 | 0.93 | 0.94 | 0.90 | 0.94 |
| RMSE | 2.67 | 2.15 | 2.33 | 2.83 | 2.57 | 2.55 | 2.42 | 2.44 | 2.08 | 2.26 | 2.08 | 2.83 |
| MAPE | 0.18 | 0.18 | 0.15 | 0.17 | 0.15 | 0.16 | 0.17 | 0.14 | 0.15 | 0.14 | 0.14 | 0.18 |
| MAE | 1.89 | 1.68 | 1.51 | 1.79 | 1.63 | 1.75 | 1.72 | 1.60 | 1.48 | 1.43 | 1.43 | 1.89 |
| SI | 0.79 | 0.48 | 0.21 | 0.76 | 0.62 | 0.48 | 0.55 | 0.32 | 0.19 | 0.07 | ||
| Rank | 10.00 | 5.00 | 3.00 | 7.00 | 6.00 | 4.00 | 4.00 | 3.00 | 2.00 | 1.00 |
- Trường hợp 2: Dự báo lưu lượng nước về hồ trước trung bình 07 ngày
| Attributes | Unit | Minimum | Maximun | Average |
|---|---|---|---|---|
| X1 | mm | 0.00 | 151.60 | 5.30 |
| X2 | mm | 0.00 | 34.21 | 5.31 |
| X3 | mm | 0.00 | 23.05 | 5.28 |
| X4 | mm | 0.00 | 34.21 | 5.30 |
| Q1 | m3/s | 1.33 | 109.68 | 10.38 |
| Q2 | m3/s | 2.27 | 59.60 | 10.34 |
| Q3 | m3/s | 2.46 | 40.58 | 10.31 |
| Q4 | m3/s | 1.93 | 82.02 | 10.38 |
| Y+07day | m3/s | 2.27 | 59.60 | 10.39 |
Bảng 3.8. Tổng hợp tính toán hệ số tương quan các mô hình
| Performance measure | Predictive technique | Testing set | ||
|---|---|---|---|---|
| Best Accuracy | Average Accuracy | Best fold | ||
| R (%) Dataset 4 | N: NORON | 0.83 | 0.79 | 4 |
| S: SVM | 0.85 | 0.81 | 4 | |
| E: REGRES | 0.85 | 0.81 | 4 | |
| R: C&R TREE | 0.82 | 0.79 | 1;3 | |
| R1: CHAID1 | 0.84 | 0.76 | 3 | |
| N+S | 0.84 | 0.80 | 4 | |
| N+R | 0.84 | 0.82 | 3 | |
| N+R1 | 0.86 | 0.81 | 3 | |
| S-R | 0.85 | 0.82 | 3 | |
| S+R1 | 0.86 | 0.80 | 3 | |
Bảng 3.9. Tổng hợp kết quả tính toán chỉ số sai số căn quân phương RMSE
| Performance measure | Predictive technique | Testing set | ||
|---|---|---|---|---|
| Best Accuracy | Average Accuracy | Best fold | ||
| RMSE (m3/s) Dataset 1 | N: NORON | 3.66 | 4.59 | 8 |
| S: SVM | 2.90 | 4.06 | 6 | |
| E: REGRES | 2.92 | 3.66 | 6 | |
| R: C&R TREE | 2.90 | 3.83 | 6 | |
| R1: CHAID1 | 2.97 | 4.01 | 6 | |
| N+S | 3.31 | 4.05 | 6 | |
| N+R | 3.25 | 3.83 | 1 | |
| N+R1 | 3.30 | 3.93 | 1 | |
| S-R | 2.73 | 3.69 | 6 | |
| S+R1 | 2.71 | 3.79 | 6 | |
Bảng 3.10. Tổng hợp kết quả tính toán chỉ số sai số phần trăm tuyệt đối trung bình MAPE
| Performance measure | Predictive technique | Testing set | ||
|---|---|---|---|---|
| Best Accuracy | Average Accuracy | Best fold | ||
| MAPE (%) Dataset 2 | N: NORON | 0.24 | 0.37 | 9 |
| S: SVM | 0.19 | 0.22 | 8 | |
| E: REGRES | 0.20 | 0.24 | 8 | |
| R: C&R TREE | 0.21 | 0.24 | 8 | |
| R1: CHAID1 | 0.20 | 0.23 | 3;6 | |
| N+S | 0.22 | 0.27 | 8 | |
| N+R | 0.20 | 0.27 | 9 | |
| N+R1 | 0.20 | 0.27 | 3 | |
| S-R | 0.18 | 0.21 | 8 | |
| S+R1 | 0.18 | 0.21 | 8 | |
Bảng 3.11. Tổng hợp kết quả tính toán chỉ số sai số tuyệt đối trung bình MAE
| Performance measure | Predictive technique | Testing set | ||
| Best Accuracy | Average Accuracy | Best fold | ||
| MAE (M3/S) Dataset 3 | N: NORON | 2.47 | 3.38 | 8 |
| S: SVM | 2.02 | 2.47 | 6 | |
| E: REGRES | 2.00 | 2.40 | 6 | |
| R: C&R TREE | 2.10 | 2.45 | 6 | |
| R1: CHAID1 | 2.03 | 2.48 | 6 | |
| N+S | 2.34 | 2.70 | 8 | |
| N+R | 2.14 | 2.60 | 8 | |
| N+R1 | 2.14 | 2.63 | 8 | |
| S-R | 1.89 | 2.27 | 6 | |
| S+R1 | 1.89 | 2.29 | 6 | |
- Lựa chọn bộ thông số tối ưu: Bộ thông số tối ưu thỏa mãn các điều kiện R đạt max; RMSE, MAPE và MAE đạt min, cụ thể:
Bảng 3.12. Đánh xếp hạng giá tổng hơp theo chỉ số tổng hợp (Synthesis Index – SIx)
| ` | N | S | E | R | R1 | N+S | N+R | N+R1 | S-R | S+R1 | Min | Max |
| R | 0.83 | 0.85 | 0.85 | 0.82 | 0.84 | 0.84 | 0.84 | 0.86 | 0.85 | 0.86 | 0.82 | 0.86 |
| RMSE | 3.66 | 2.90 | 2.92 | 2.90 | 2.97 | 3.31 | 3.25 | 3.30 | 2.73 | 2.71 | 2.71 | 3.66 |
| MAPE | 0.24 | 0.19 | 0.20 | 0.21 | 0.20 | 0.22 | 0.20 | 0.20 | 0.18 | 0.18 | 0.18 | 0.24 |
| MAE | 2.47 | 2.02 | 2.00 | 2.10 | 2.03 | 2.34 | 2.14 | 2.14 | 1.89 | 1.89 | 1.89 | 2.47 |
| SI | 0.96 | 0.18 | 0.28 | 0.51 | 0.39 | 0.61 | 0.41 | 0.36 | 0.11 | 0.02 | ||
| Rank | 10.00 | 3.00 | 3.00 | 6.00 | 4.00 | 5.00 | 4.00 | 3.00 | 2.00 | 1.00 |
3.4. Bình luận về các kết quả phân tích:
Qua phân tích, huấn luyện, kiểm định các mô hình thuật toán máy học cho 02 trường hợp dự báo lưu lượng nước trung bình về hồ thủy điện A Lưới trước 3 ngày và 7 ngày nêu trên, nhận thấy:
- Trường hợp dự báo lưu lượng nước về hồ trước 03 ngày:
- Các thuật toán đơn cho kết quả sai số phần trăm tuyệt đối trung bình (MAPE) trong khoảng từ 15% đến 18%; Hệ số tương quan tuyến tính R trong khoảng từ 90%-94% và chỉ số tổng hợp SI trong khoảng từ 0.21 đến 0.79.
- Các thuật toán kết hợp cho kết quả sai số phần trăm tuyệt đối trung bình (MAPE) trong khoảng từ 14% đến 16%; Hệ số tương quan tuyến tính R trong khoảng từ 93%-94% và chỉ số tổng hợp SI trong khoảng từ 0.07 đến 0.55.
- Trường hợp dự báo lưu lượng nước về hồ trước 07 ngày:
- Các thuật toán đơn cho kết quả sai số phần trăm tuyệt đối trung bình (MAPE) trong khoảng từ 18% đến 22%; Hệ số tương quan tuyến tính R trong khoảng từ 82%-86% và chỉ số tổng hợp SI trong khoảng từ 0.11 đến 0.96.
- Các thuật toán kết hợp cho kết quả sai số phần trăm tuyệt đối trung bình (MAPE) trong khoảng từ 18% đến 24%; Hệ số tương quan tuyến tính R trong khoảng từ 82%-86% và chỉ số tổng hợp SI trong khoảng từ 0.02 đến 0.61.
Với điều kiện mô hình thuật toán tối ưu nhất khi có giá trị R cao và các giá trị RMSE, MAE và MAPE . Do vậy theo các bảng tổng hợp trên sẽ chọn mô hình thuật toán E+R1 (Regression – CHAID1) để dự báo lưu lượng nước về hồ trước 03 ngày và thuật toán S+R1 (SVM+ CHAID1) để dự báo lưu lượng nước về hồ trước 07 ngày.
1. Kết luận
Công trình thủy điện A Lưới, tỉnh Thừa Thiên Huế đã được vận hành hồ chứa để phát điện từ năm 2012, hơn 9 năm thực tế vận hành, vấn đề dự báo lưu lượng đến hồ chứa đã được Công ty quan tâm để chủ động trong việc vận hành phát điện và chào giá bán điện trên thị trường điện cạnh tranh.
Đề tài đã có một phương pháp nghiên cứu mới để dự báo lưu lượng nước đến hồ thủy điện A Lưới dựa trên cơ sở bộ dữ liệu lượng mưa (Xmm) và lưu lượng nước (Q m3/s) trung bình ngày về lưu vực trong các năm quá khứ, đề tài đã nghiên cứu ứng dụng các thuật toán máy học để dự báo lưu lượng nước về hồ thủy điện A Lưới trước trung bình 03 ngày và trước trung bình 07 ngày. Kết quả nghiên cứu đã lựa chọn được thuật toán tối ưu như sau:
Bảng Trường hợp dự báo lưu lượng nước về hồ chứa thủy điện A Lưới trước trung bình 03 ngày
| Mô hình dự đoán | R (%) | MAE (MPa) | RMSE (MPa) | MAPE (%) |
| REGRESSION + CHAID1 | 94 | 1.43 | 2.26 | 14 |
Bảng Trường hợp dự báo lưu lượng nước về hồ chứa thủy điện A Lưới trước trung bình 07 ngày
| Mô hình dự đoán | R (%) | MAE (MPa) | RMSE (MPa) | MAPE (%) |
| SVM+CHAID1 | 86 | 1.89 | 2.71 | 18 |
Việc ứng dụng các thuật toán máy học để dự báo lưu lượng nước về hồ thủy điện A Lưới trước trung bình 03 ngày và 07 ngày là một phương pháp mới cho chủ hồ xem xét đưa ra quyết định lựa chọn lưu lượng nước để phát điện so với các phương pháp dự báo khác.
Đóng góp của đề tài nghiên cứu là đóng góp vào lĩnh vực nghiên cứu ứng dụng công nghê thông tin trong việc giải quyết các bài toán kỹ thuật hỗ trợ ra quyết định và thiết kế, quản lý.
2. Kiến nghị
Đề tài đang dừng ở mức độ nghiên cứu ứng dụng thuật toán máy học cơ bản để dự báo lưu lượng nước về hồ thủy điện A Lưới, kết quả với các chỉ số đánh giá cho thấy sai số dự báo có thể tiếp tục được cải thiện khi được xem xét tối ưu bằng các thuật toán máy học khác. Ứng dụng thuật toán máy học có thể tiếp tục được nghiên cứu cho dự báo lũ, dự báo lưu lượng về hồ trong mùa khô, mùa mưa.
Cần phải có những nghiên cứu tiếp theo về ứng dụng thuật toán máy học để dự báo lưu lượng về hồ chứa cho những khu vực khác, đặc biệt là những khu vực mà tài liệu đo đạc tốt hơn để tổng kết đánh giá và đưa mô hình vào công tác dự báo tác nghiệp.
Nếu chúng ta tiếp tục tận dụng cuộc cách mạng dữ liệu sẽ thúc đẩy tiến bộ trong ngành thủy văn. Các yếu tố như phát triển các kiểu dữ liệu mới, khám phá thông tin dự báo về khí hậu, và khám phá các hướng phân tích mới để hỗ trợ giám sát và dự đoán môi trường tất cả đều mang lại cơ hội phát triển./.
E:\DỮ LIỆU COP CỦA CHỊ YẾN\DAI HOC DA NANG\QUAN LY XAY DUNG\NGUYEN HUU HUY\SAU BAO VE\TOM TAT


