
Ứng dụng Random Forest để tư vấn chọn lộ trình học trong học chế tín chỉ
MỞ ĐẦU
Trong những năm gần đây, công nghệ thông tin phát triển mạnh mẽ và việc ứng dụng cộng nghệ thông tin trong nhiều lĩnh vực như đời sống, kinh tế xã hội đã làm lượng dữ liệu được thu thập và lưu trữ ở các hệ thống thông tin tăng lên một cách nhanh chóng dẫn tới sự bùng nổ thông tin. Lượng dữ liệu đó là một tài nguyên vô giá nếu như chúng ta biết cách phát hiện và khai thác những thông tin hữu ích có trong đó. Các phương pháp khai thác dữ liệu truyền thống ngày càng không đáp ứng được như cầu thục tế.
Với những lý do đó, để đáp ứng nhu cầu xử lý, phân tích, sử dụng thông tin hiệu quả hơn, đã làm phát triển kỹ thuật mới và với kỹ thuật này cho phép ta khai thác được tri thức hữu dụng từ CSDL lớn được gọi là các kỹ thuật khai phá dữ liệu. Các kỹ thuật khai phá dữ liệu ra đời đã cho phép ta khai thác được những tri thức hữu dụng bằng việc trích xuất những thông tin có mối quan hệ hoặc mối tương quan nhất định từ một kho dữ liệu lớn (cực lớn) mà bình thường không thể nhận diện được từ đó giải quyết các bài toán tìm kiếm, dự báo các xu thế, các hành vi trong tương lai, và nhiều tính năng thông minh khác. Các kỹ thuật khai phá dữ liệu đã được ứng dụng trong nhiều lĩnh vực như: kinh tế, tài chính, y tế, giáo dục.
Trong việc ứng dụng khai phá dữ liệu vào nhiều lĩnh vực khác nhau của đời sống, khai phá dữ liệu trong lĩnh vực giáo dục đang dần có được sự quan tâm đúng mức. Giáo dục đào tạo có nhiệm vụ định hướng và hoạch định chính sách trong tương lai một cách đúng đắn và kịp thời. Để những đối tượng chính của giáo dục là thế hệ trẻ, là lực lượng kế thừa của việc xây dựng, bảo vệ và phát triển đất nước có môi trường tốt phát huy khả năng của mình.
Ngày nay, các trường đại học và cao đẳng đa số chuyển sang đào tạo theo học chế tín chỉ. Việc tư vấn học tập, liên quan đến lựa chọn lộ trình học trong học chế tín chỉ phù hợp nhầm đạt được kết quả học tập cao nhất cho mỗi sinh viên rất được quan tâm.
Trước thực tế đó và được sự đồng ý của TS. Nguyễn Trần Quốc Vinh, tôi chọn đề tài “Ứng dụng Random Forest để tư vấn chọn lộ trình học trong học chế tín chỉ”.
– Nghiên cứu về khai phá dữ liệu, phân lớp dữ liệu và Random Forest.
– Ứng dụng để khai phá dữ liệu sinh viên, qua đó tư vấn chọn lộ trình học trong học chế tín chỉ phù hợp cho sinh viên để đạt được kết quả tốt.
a. Đối tượng nghiên cứu
– Các kỹ thuật khai phá dữ liệu;
– Tổng quan về phân lớp dữ liệu;
– Random Forest;
b. Phạm vi nghiên cứu
– Triển khai kỹ thuật khai phá dữ liệu sử dụng phân lớp dữ liệu dựa trên cây quyết định và Random Forest.
– Dữ liệu tại trường Cao Đẳng Kinh tế – Kỹ thuật Quảng Nam gồm: kết quả học tập và thông tin các nhân của 2000 sinh viên với cách ngành học như sau: Kế toán, Quản trị, Quản lý đất đai, Nuôi trồng thủy sản, Lâm nghiệp…
a. Nghiên cứu lý thuyết
– Tổng hợp và nghiên cứu các tài liệu liên quan lý thuyết khai phá dữ liệu, phân lớp dữ liệu, cây quyết định và Random Forest.
– Phân tích và thiết kế mô hình phân lớp với Random Forest.
b. Nghiên cứu thực nghiệm
– Sử dụng mô hình Random Forest trên CSDL lý lịch, lộ trình học chế tín chỉ, kết quả học tập của sinh viên tại trường Cao Đẳng Kinh tế – Kỹ thuật Quảng Nam để tạo ra mô hình phân lớp để dự đoán kết quả học tập.

– Ứng dụng để tư vấn chọn lộ trình học cho sinh viên.
a. Về mặt khoa học
b. Về mặt thực tiễn
Nội dụng chính của luận văn chia thành 3 chương:
Chương 1: Nghiên cứu tổng quan, chương này giới thiệu tổng quan về khai phá dữ liệu, các kỹ thuật khai phá dữ liệu, mô hình tổng quan về khai phá dữ liệu. Giới thiệu về phân lớp dữ liệu và cây quyết định trong phân lớp dữ liệu, thuật toán xây dựng cây quyết định.
Chương 2: Nghiên cứu random forest và ứng dụng để xây dựng mô hình cho bài toán, chương này nghiên cứu tổng quan về random forest, thuật toán và mô hình phân lớp với random forest. Ứng dụng để xây dựng mô hình phân lớp với dữ liệu sinh viên của trường Cao Đẳng Kinh tế – Kỹ thuật Quảng Nam nhằm dự đoán kết quả học tập cho sinh viên.
Chương 3: Đánh giá kết quả của mô hình random forest và ứng dụng để tư vấn lộ trình học cho sinh viên, chương này trình bày các kết quả phân lớp dữ liệu bằng random forest và so sánh với một số phương pháp cũ đã được sử dụng nhiều. Ứng dụng mô hình phân lớp đó để tư vấn lộ trình học trong học chế tín chỉ cho sinh viên.
CHƯƠNG 1
NGHIÊN CỨU TỔNG QUAN
TỔNG QUAN VỀ KHAI PHÁ DỮ LIỆU
Sơ lược về khai phá dữ liệu
Có thể có định nghĩa về khai phá dữ liệu như sau: Khai phá dữ liệu là quá trình phát hiện các mô hình, các tổng kết khác nhau và các giá trị được lấy từ tập dữ liệu cho trước [9].
Hay, có thể định nghĩa như sau: Khai phá dữ liệu được dùng để mô tả quá trình phát hiện tri thức trong CSDL, là quá trình khảo sát và phân tích một khối lượng lớn các dữ liệu được lưu trữ trong các cơ sở dữ liệu, kho dữ liệu…để tìm ra mối quan hệ, mối liên kết giữa các dữ liệu mà bình thường khó có thể nhận diện được, từ đó trích xuất ra các thông tin mới lạ, có ích, có giá trị tìm ẩn bên trong.
Mô hình khai phá dữ liệu
Các chức năng cơ bản của khai phá dữ liêu
Ứng dụng của khai phá dữ liệu
Các bước xây dựng hệ thống khai phá dữ liệu
Mô hình luồng dữ liệu
Các bước của một hệ thống khai phá dữ liệu
Kiến trúc điển hình của một hệ thống phai khá dữ liệu
Kiến trúc của một hệ thống khai phá dữ liệu điển hình thường gồm những thành phần chính sau:
Cơsởtri thức
MáychủCSDL
Máykhaiphádữliệu
Đánhgiámẫu
Giaodiệnngườidùng
CSDL
Làmsạchdữliệuvàlọcdữliệu
Hình 1.3. Kiến trúc điển hình của một hệ thống khai phá dữ liệu
PHÂN LỚP TRONG KHAI PHÁ DỮ LIỆU
Phân lớp dữ liệu
Ngày nay phân lớp dữ liệu (classification) là một trong những hướng nghiên cứu chính của khai phá dữ liệu. Thực tế đặt ra nhu cầu là từ một cơ sỡ dữ liệu với nhiều thông tin ẩn con người có thể trích rút ra các quyết định nghiệp vụ thông minh.
Quá trình phân lớp dữ liệu
Quá trình phân lớp gồm 2 bước:
Bước thứ nhất (learning): quá trình học nhầm xây dựng một mô hình mô tả tập các lớp dữ liệu hay các khái niệm định trước.
Bước thứ hai (classification): bước này dùng mô hình đã xây dựng được ở bước thứ nhất để phân lớp dữ liệu mới.
Một số kỹ thuật phân lớp dữ liệu
Có thể liệt kê ra đây các kỹ thuật phân lớp đã được sử dụng trong những năm qua:
– Phân lớp cây quyết định (Decision tree classification)
– Bộ phân lớp Bayesian (Bayesian classifier)
– Mô hình phân lớp K-hàng xóm gần nhất (K-nearest neighbor classifier)
– Mạng nơron
– Phân tích thống kê
– Các thuật toán di truyền
– Phương pháp tập thô (Rough set Approach)
Các vấn đề liên quan đến phân lớp dữ liệu
Chuẩn bị dữ liệu cho viêc phân lớp
So sánh các mô hình phân lớp
Phương pháp đánh giá độ chính xác của mô hình phân lớp
CÂY QUYẾT ĐỊNH TRONG PHÂN LỚP DỮ LIỆU
Giới thiệu
Cây quyết định là biểu đồ phát triển có cấu trúc dạng cây, như mô tả sau:
Gió
Quang
Cảnh
Âm u
Mưa
Mạnh
Nhẹ
Độ Ẩm
Nắng
Cao
Trungbình
Hình 1.12. Ví dụ cây quyết định
Trong cây quyết định:
– Gốc: là nút trên cùng của cây.
– Nút trong: biểu diễn một kiểm tra trên một thuộc tính đơn (hình chữ nhật).
– Nhánh: biểu diễn các kết quả của kiểm tra trên nút (mũi tên).
– Nút lá: biểu diễn lớp hay sự phân phối lớp (hình tròn).
Để phân lớp mẫu dữ liệu chưa biết, giá trị các thuộc tính của mẫu được đưa vào kiểm tra trên cây quyết định. Mỗi mẫu tương ứng có một đường đi từ gốc đến lá và lá biểu diễn dự đoán giá trị phân lớp mẫu đó.
Đánh giá cây quyết định trong lĩnh vực khai phá dữ liệu
Cây quyết định có các ưu điểm chính sau:
– Câu quyết định dễ hiểu.
– Dễ dàng tính toán trong khi phân lớp.
– Khả năng xử lý với cả thuộc tính liên tục và thuộc tính rời rạc.
– Thể hiện rõ ràng những thuộc tính tốt nhất.
Xây dựng cây quyết định
Quá trình xây dựng cây quyết định
Gồm 2 giai đoạn:
– Giai đoạn thứ nhất phát triển cây quyết định.
– Giai đoạn thứ hai cắt, tỉa bớt các cành nhánh trên cây quyết định.
Thuật toán xây dựng cây quyết định
Tư tưởng chung
Các thuật toán phân lớp như C4.5 (Quinlan, 1993), CDP (Agrawal và các tác giả khác, 1993), SLIQ (Mehta và các tác giả khác, 1996) và SPRINT (Shafer và các tác giả khác, 1996) đều sử dụng phương pháp của Hunt làm tư tưởng chủ đạo . Phương pháp này được Hunt và các đồng sự nghĩ ra vào những năm cuối thập kỷ 50 đầu thập kỷ 60 [9].
Xây dụng cây quyết định bằng thuật toán C4.5
Thuật toán C4.5
C4.5 là sự kế thừa của của thuật toán học máy bằng cây quyết định dựa trên nền tảng là kết quả nghiên cứu của HUNT và các cộng sự của ông (Hunt 1962). Phiên bản đầu tiên ra đời là ID3 (Quinlan, 1979). Năm 1993, J. Ross Quilan đã kế thừa các kết quả và phát triển thành C4.5.
Tư tưởng phát triển cây quyết định của C4.5 là phương pháp HUNT. Chiến lược phát triển theo độ sâu (depth-first strategy) được áp dụng cho C4.5. Thuật toán xét tất cả các phép thử có thể để phân chia tập dữ liệu đã cho và chọn ra một phép thử có giá trị Gain Ratio tốt nhất. Gain Ratio là một đại lượng để đánh giá độ hiệu quả của thuộc tính dùng để thực hiện phép tách trong thuộc toán để phát triển cây quyết định. Gain Ratio được tính dựa trên kết quả tính toán đại lượng Information Gain theo công thức:
GainRatioA(T) = (1)
Với
Và (Infomation Gain) được tính như sau :
- T là tập dữ liệu huấn luyện gồm , mỗi phần tử gồm n thuộc tính.
- Với pi là xác suất mà một bản ghi tùy ý trong T thuộc về lớp Ci, i=1,…,m ; là tập các phần tử của lớp Ci trong T; ta có:
- Lượng thông tin (entropy) cần thiết để phân loại một bản ghi trong T là :
- Thuộc tính A dùng để phân chia T thành v phân hoạch: T1,T2,…,Tj,…,Tv ; mỗi phân hoạch Tj gồm phần tử trong T ; lượng thông tin cần thiết để phân loại một phần tử trong T dựa trên thuộc tính A là:
- Thông tin thu được (Infomation Gain) từ việc phân chia với thuộc tính A là:
GainA(T)= Info(T) – InfoA(T) (2)
Mã giả của thuật toán C4.5 [9]:
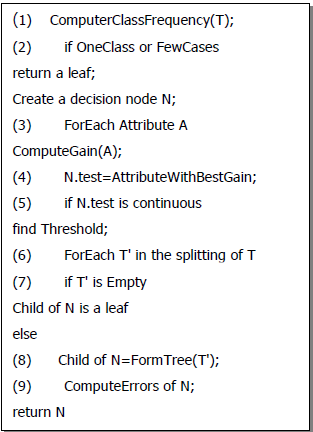
Hình 1.13. Mã giải thuật toán C4.5
C4.5 dùng Gain Ratio làm độ đo lựa chọn thuộc tính “tốt nhất”
Chuyển đổi từ cây quyết định sang luật
C4.5 là một thuật toán hiệu quả cho dữ liệu vừa và nhỏ
CHƯƠNG 2
NGHIÊN CỨU RANDOM FOREST VÀ ỨNG DỤNG
ĐỂ XÂY DỰNG MÔ HÌNH CHO BÀI TOÁN
RANDOM FOERST
Cơ sở và định nghĩa
Random Forest là một phương pháp học quần thể để phân loại, hồi quy và các nhiệm vụ khác, hoạt động bằng cách xây dựng vô số các cây quyết định trong thời gian đào tạo và đầu ra là tập hợp mô hình phân lớp hoặc hồi quy của những cây riêng biệt. Nó như là một nhóm phân loại và hồi quy các cây không cắt tỉa được làm từ các lựa chọn ngẫu nhiên của các mẫu dữ liệu huấn luyện. Tính năng ngẫu nhiên được chọn trong quá trình cảm ứng. Dự đoán được thực hiện bằng cách kết hợp dự đoán của quần thể (đa số phiếu để phân loại hoặc trung bình cho hồi quy).
Tóm tắt giải thuật
- Đầu vào là tập dữ liệu đào tạo.
- Đầu ra là mô hình Random Forest, Random Forest là tập hợp nhiều cây quyết định Ntree.
Với mỗi Cây Ntree được xây dựng bằng các sử dụng thuật toán sau [15]:
- Với N là số lượng các trường hợp của dữ liệu đào tạo, M là số lượng các biến trong việc phân loại.
- Lấy m là số các biến đầu vào được sử dụng để xác định việc phân chia tại 1 Nút của cây, m < M.
- Chọn 1 tập huấn luyện cho cây bằng cách chọn n ngẫu nhiên với sự thay thế từ tất cả các trường hợp đào tạo có sẵn N. Sử dụng các phần còn lại để ước lượng các lỗi của cây, bằng cách dự đoán các lớp của chúng.
- Với mỗi nút của cây, chọn ngẫu nhiên m là cơ sở phân chia tại nút đó (độc lập với mỗi nút) . Tính chia tốt nhất dựa trên các biến m trong tập huấn luyện n.
- Mỗi cây được trồng hoàn toàn và không tỉa ( có thể được sử dụng trong vệ xây dựng một bộ phân loại như các cây bình thường).
Đối với mỗi dự doán mới được đưa vào. Nó được gán nhãn của mẫu đạo tạo trong các nút cuối để kết thúc. Thủ tục sẽ được lập lại qua tất cả các cây Ntree, và đa số phiếu bình chọn với phân lớp hay trung bình với hồi quy của các cây Ntree là dự đoán mô hình.
F:\DỮ LIỆU COP CỦA CHỊ YẾN\DAI HOC DA NANG\LUAN VAN 2015\KHOA HOC MAY TINH\TRAN HOANG BINH\CD


