
Nghiên cứu cây quyết định và ứng dụng để phân loại khách hàng vay vốn tại ngân hàng Vietinbank chi nhánh Kon Tum
Trong gần hai thập kỷ qua, các hệ thống cơ sở dữ liệu đã đem lại những lợi ích vô cùng to lớn cho nhân loại. Cùng với sự phát triển của Công nghệ Thông tin và ứng dụng của nó trong đời sống – kinh tế – xã hội, lượng dữ liệu thu thập được ngày càng nhiều theo thời gian, làm xuất hiện ngày càng nhiều các hệ thống cơ sở dữ liệu có kích thước lớn. Người ta lưu trữ những dữ liệu này vì cho rằng nó ẩn chứa những giá trị nhất định nào đó. Tuy nhiên theo thống kê thi chỉ có một lượng nhỏ của những dữ liệu này (khoảng dưới10%) là luôn được phân tích, số còn lại họ không biết sẽ phải làm gì và có thể làm gì với những dữ liệu này, nhưng họ vẫn tiếp tục thu thập và lưu trữ vì hy vọng những dữ liệu này sẽ cung cấp cho họ những thông tin quý giá một cách nhanh chóng để đưa ra những quyết định kịp thời vào một lúc nào đó. Chính vì vậy, các phương pháp quản trị và khai thác cơ sở dữ liệu truyền thống ngày càng không đáp ứng được thực tế đã làm phát triển một khuynh hướng kỹ thuật mới đó là Kỹ thuật phát hiện tri thức và khai phá dữ liệu (KDD – Knowledge Discovery and Data Mining).
Kỹ thuật phát hiện tri thức và khai phá dữ liệu đã và đang được nghiên cứu, ứng dụng trong nhiều lĩnh vực khác nhau trên thế giới, tại Việt Nam kỹ thuật này còn tương đối mới mẻ tuy nhiên cũng đang được nghiên cứu và bắt đầu đưa vào một số ứng dụng thực tế. Vì vậy, hiện nay ở nước ta vấn đề phát hiện tri thức và khai phá dữ liệu đang thu hút được sự quan tâm của nhiều người và nhiều công ty phát triển ứng dụng Công nghệ Thông tin. Được đánh giá sẽ tạo ra cuộc cách mạng trong thế kỷ 21, khai phá dữ liệu sẽ ngày càng được ứng dụng phổ biến trong các lĩnh vực kinh tế, xã hội: ngân hàng, truyền thông, quảng cáo…
Có nhiều phương pháp phân lớp được đề xuất, tuy nhiên không có phương pháp tiếp cận phân loại nào là tối ưu và chính xác hơn hẳn những phương pháp khác. Dù sao với mỗi phương pháp có một lợi thế và bất lợi riêng khi sử dụng. Một trong những công cụ khai phá tri thức hiệu quả hiện nay là sử dụng cây quyết định để tìm ra các luật phân lớp. Với mong muốn nghiên cứu về việc ứng dụng cây quyết định để phân loại khách hàng của Ngân hàng thương mại, tôi đã chọn đề tài “Nghiên cứu cây quyết định và ứng dụng để phân loại khách hàng vay vốn tại ngân hàng Vietinbank chi nhánh Kon Tum”.
- Nghiên cứu các thuật toán xây dựng cây quyết định ID3.
- Áp dụng mô hình cây quyết định (ID3: Decision Tree) vào việc phân loại khách hàng vay vốn tại ngân hàng Vietinbank chi nhánh Kon Tum.
3. Đối tượng và phạm vi nghiên cứu
- Đối tượng nghiên cứu
- Bài toán phân lớp dữ liệu trong khai phá dữ liệu;
- Cây quyết định;
- Phạm vi nghiên cứu
- Nghiên cứu về thuật toán ID3;
- Phân lớp dữ liệu khách hàng, cụ thể: khách hàng vay vốn tại ngân hàng Vietinbank chi nhánh Kon Tum.
Báo cáo luận văn gồm các phần chính như sau:
MỞ ĐẦU
CHƯƠNG 1. TỔNG QUAN VỀ KHAI PHÁ DỮ LIỆU
CHƯƠNG 2. CÂY QUYẾT ĐỊNH TRONG KHAI PHÁ DỮ LIỆU CHƯƠNG 3. ỨNG DỤNG CÂY QUYẾT ĐỊNH TRONG PHÂN LOẠI KHÁCH HÀNG VAY VỐN TẠI NGÂN HÀNG VIETINBANK CHI NHÁNH KON TUM
KẾT LUẬN VÀ HƯỚNG PHÁT TRIỂN.

TỔNG QUAN VỀ KHAI PHÁ DỮ LIỆU
GIỚI THIỆU VỀ KHAI PHÁ DỮ LIỆU
Khám phá tri thức
Quá trình khám phá dữ liệu gồm các bước cơ bản sau đây [1][2][9]:
Bước 1: Xác định vấn đề và lựa chọn nguồn dữ liệu (Problem Understanding anh Data Understanding)
Bước 2: Chuẩn bị dữ liệu (Data preparation)
Bước 3: Khai phá dữ liệu (Data Mining)
Bước 4: Đánh giá mẫu (Partern Evalution)
Bước 5: Biểu diễn tri thức và triển khai (Knowlegde presentation and Deployment)
Tóm lại: KDD là một quá trình kết xuất ra tri thức từ kho dữ liệu mà trong đó khai phá dữ liệu là công đoạn quan trọng nhất [2], [3],[8].
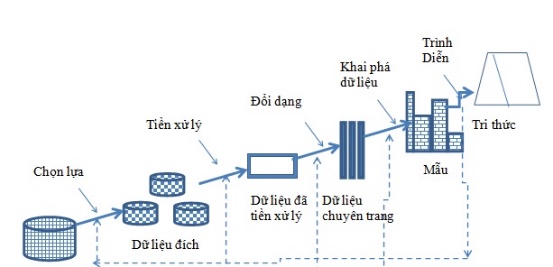
Hình 1.1: Quá trình phát hiện tri thức trong CSDL
Khai phá dữ liệu
Khai phá dữ liệu được dùng để mô tả quá trình phát hiện ra tri thức trong CSDL. Quá trình khai phá dữ liệu bao gồm các giai đoạn [1][3]:
Giai đoạn 1: Gom dữ liệu
Giai đoạn 2: Trích lọc dữ liệu
Giai đoạn 3: Làm sạch, tiền xử lý và chuẩn bị trước dữ
Giai đoạn 4: Chuyển đổi dữ liệu
Giai đoạn 5: Phát hiện và trích mẫu dữ
Giai đoạn 6: Đánh giá kết quả mẫu
Quá khai phá dữ liệu được mô hình hóa một cách tổng quát như hình vẽ dưới đây [2][7]:
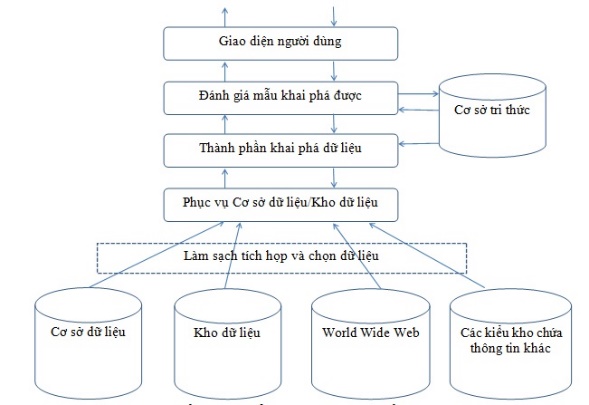
Hình 1.2: Kiến trúc điển hình của hệ thống khai phá dữ liệu
ỨNG DỤNG CỦA KHAI PHÁ DỮ LIỆU
Data Mining tuy là một hướng tiếp cận mới nhưng thu hút được rất nhiều sự quan tâm của các nhà nghiên cứu và phát triển nhờ vào những ứng dụng thực tiễn của nó. Sau đây là một số lĩnh vực mà Data mining đang được ứng dụng rộng rãi:
- Phân tích dữ liệu tài chính (Financial Data Analysis)
- Công nghiệp bán lẻ (Retail Industry)
- Công nghiệp viễn thông (Telecommunication Industry)
- Phân tích dữ liệu sinh học (Biological Data Analysis)
- Phát hiện xâm nhập (Intrusion Detection)
- Một số ứng dụng trong khoa học (Scientific Applications)
CÁC PHƯƠNG PHÁP KHAI PHÁ DỮ LIỆU THÔNG DỤNG
Phân lớp (Classification)
Ngày nay phân lớp dữ liệu (classification) là một trong những hướng nghiên cứu chính của khai phá dữ liệu. Thực tế đặt ra nhu cầu là từ một cơ sở dữ liệu với nhiều thông tin ẩn con người có thể trích rút ra các quyết định nghiệp vụ thông minh. Phân lớp và dự đoán là hai dạng của phân tích dữ liệu nhằm trích rút ra một mô hình mô tả các lớp dữ liệu quan trọng hay dự đoán xu hướng dữ liệu tương lai. Phân lớp dự đoán giá trị của những nhãn xác định (categorical label) hay những giá trị rời rạc (discrete value), có nghĩa là phân lớp thao tác với những đối tượng dữ liệu mà có bộ giá trị là biết trước. Trong khi đó, dự đoán lại xây dựng mô hình với các hàm nhận giá trị liên tục.
Quá trình phân lớp dữ liệu gồm hai bước [4][5]:
Bước thứ nhất (Learning)
Quá trình học nhằm xây dựng một mô hình mô tả một tập các lớp dữ liệu hay các khái niệm định trước. Đầu vào của quá trình này là một tập dữ liệu có cấu trúc được mô tả bằng các thuộc tính và được tạo ra từ tập các bộ giá trị của các thuộc tính đó. Mỗi bộ giá trị được gọi chung là một phần tử dữ liệu (data tuple), có thể là các mẫu (sample), ví dụ (example), đối tượng (object), bản ghi (record) hay trường hợp (case). Luận văn sử dụng các thuật ngữ này với nghĩa tương đương. Trong tập dữ liệu này, mỗi phần tử dữ liệu được giả sử thuộc về một lớp định trước, lớp ở đây là giá trị của một thuộc tính được chọn làm thuộc tính gán nhãn lớp hay thuộc tính phân lớp (class label attribute). Đầu ra của bước này thường là các quy tắc phân lớp dưới dạng luật dạng if-then, cây quyết định, công thức logic, hay mạng nơron. Quá trình này được mô tả như trong hình 1.3
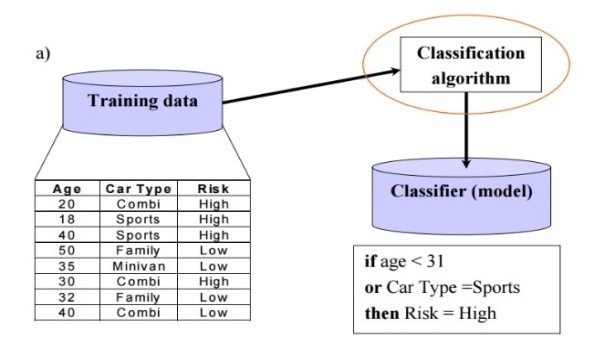
Hình 1.3 : Quá trình phân lớp dữ liệu – (a) Bước xây dựng mô hình phân lớp
Bước thứ hai (Classification)
Bước thứ hai dùng mô hình đã xây dựng ở bước trước để phân lớp dữ liệu mới. Trước tiên độ chính xác mang tính chất dự đoán của mô hình phân lớp vừa tạo ra được ước lượng. Holdout là một kỹ thuật đơn giản để ước lượng độ chính xác đó. Kỹ thuật này sử dụng một tập dữ liệu kiểm tra với các mẫu đã được gán nhãn lớp. Các mẫu này được chọn ngẫu nhiên và độc lập với các mẫu trong tập dữ liệu đào tạo. Độ chính xác của mô hình trên tập dữ liệu kiểm tra đã đưa là tỉ lệ phần trăm các các mẫu trong tập dữ liệu kiểm tra được mô hình phân lớp đúng (so với thực tế).
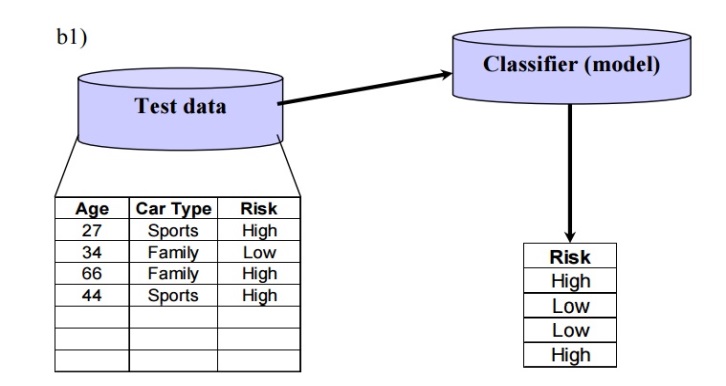
Hình 1.4: Quá trình phân lớp dữ liệu – (b1)Ước lượng độ chính xác của mô hình
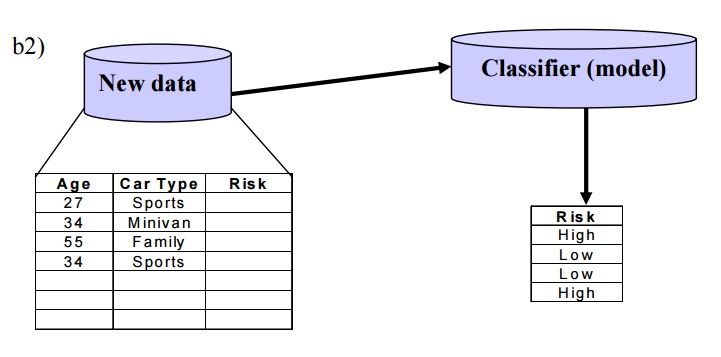
Hình 1.5: Quá trình phân lớp dữ liệu – (b2) Phân lớp dữ liệu mới
Có thể liệt kê ra đây các kỹ thuật phân lớp đã được sử dụng trong những năm qua:
- Phân lớp cây quyết định (Decision tree classification)
- Bộ phân lớp Bayesian (Bayesian classifier)
- Mô hình phân lớp K-hàng xóm gần nhất (K-nearest neighbor classifier)
- Mạng nơron
- Phân tích thống kê
- Các thuật toán di truyền
- Phương pháp tập thô (Rough set Approach)
Phân cụm (Clustering)
Phân cụm là kỹ thuật rất quan trọng trong khai phá dữ liệu, nó thuộc lớp các phương pháp Unsupervised Learning trong Machine Learning. Có rất nhiều định nghĩa khác nhau về kỹ thuật này, nhưng về bản chất ta có thể hiểu phân cụm là các qui trình tìm cách nhóm các đối tượng đã cho vào các cụm (clusters), sao cho các đối tượng trong cùng 1 cụm tương tự (similar) nhau và các đối tượng khác cụm thì không tương tự (Dissimilar) nhau.
Mục đích của phân cụm là tìm ra bản chất bên trong các nhóm của dữ liệu.
Luật kết hợp (Association Rules)
Khai phá luật kết hợp được thực hiện qua 2 bước:
- Bước 1 : Tìm tất cả các tập mục phổ biến, một văn bản phổ biến được xác định qua độ hỗ trợ và thỏa mãn độ hỗ trợ cực tiểu.
- Bước 2: Sinh ra các luật kết hợp mạnh từ tập mục phổ biến, các luật phải thỏa mãn độ hỗ trợ cực tiểu và độ tin cậy cực tiểu.
ỨNG DỤNG KHAI PHÁ DỮ LIỆU TRONG LĨNH VỰC NGÂN HÀNG
Ngành công nghiệp ngân hàng trên toàn thế giới đã trải qua những thay đổi to lớn trong cách thức kinh doanh. Với việc thực hiện các nhiệm vụ kinh doanh đặc thù của mình trong thời gian gần đây, các ngân hàng đã có sự thay đổi lớn đó là chấp nhận và áp dụng công nghệ thông vào việc kinh doanh của mình. Như một kết quả hiển nhiên, việc thực hiện giao dịch đã trở nên dễ dàng và đồng thời khối lượng dữ liệu từ các giao dịch này đã tăng lên đáng kể. Nó là vượt quá khả năng của con người để phân tích số lượng dữ liệu thô khổng lồ này và chuyển đổi nó thành tri thức hữu ích cho các tổ chức.
Marketing
Một trong những lĩnh vực được ứng dụng rộng rãi nhất cho ngành ngân hàng của kỹ thuật khai phá dữ liệu đó là lĩnh vực quảng bá sản phẩm. Bộ phận tiếp thị và bán hàng của các Ngân hàng có thể sử dụng kỹ thuật khai phá dữ liệu để phân tích cơ sở dữ liệu về khách hàng.
Quản lý rủi ro
Khai phá dữ liệu được sử dụng rộng rãi để quản lý rủi ro trong ngành công nghiệp ngân hàng.
Phát hiện gian lận
Một lĩnh vực khác trong khai phá dữ liệu có thể được sử dụng trong ngành công nghiệp ngân hàng là việc phát hiện gian lận.
Quản trị quan hệ khách hàng
Tìm kiếm khách hàng, tăng giá trị của khách hàng và duy trì khách hàng.
KẾT LUẬN
Trong chương này, luận văn đã giới thiệu tổng quan về khai phá dữ liệu, ứng dụng của khai phá dữ liệu, một số phương pháp khai phá dữ liệu thông dụng. Trong chương sau, luận văn sẽ trình bày nội dung lý thuyết và ứng dụng của thuật toán khai phá dữ liệu thông dụng : Thuật toán cây quyết định ID3. Đó là một thuật toán được ứng dụng để khai phá dữ liệu trong các lĩnh vực khác nhau, đặc biệt trong lĩnh vực ngân hàng.
CÂY QUYẾT ĐỊNH TRONG KHAI PHÁ DỮ LIỆU
TỔNG QUAN VỀ PHƯƠNG PHÁP HỌC THEO CÂY QUYẾT ĐỊNH
Giới thiệu chung
Trong lĩnh vực học máy, cây quyết định là một kiểu mô hình dự báo (predictive model), nghĩa là một ánh xạ từ các quan sát về một sự vật/hiện tượng tới các kết luận về giá trị mục tiêu của sự vật/hiện tượng. Mỗi một nút trong (internal node) tương ứng với một biến; đường nối giữa nó với nút con của nó thể hiện một giá trị cụ thể cho biến đó. Mỗi nút lá đại diện cho giá trị dự đoán của biến mục tiêu, cho trước các giá trị của các biến được biểu diễn bởi đường đi từ nút gốc tới nút lá đó. Kỹ thuật học máy dùng trong cây quyết định được gọi là học bằng cây quyết định, hay chỉ gọi với cái tên ngắn gọn là cây quyết định[6].
Các kiểu cây quyết định
Cây quyết định còn có hai tên khác:
- Cây hồi quy (Regression tree): ước lượng các hàm giá có giá trị là số thực thay vì được sử dụng cho các nhiệm vụ phân loại. (ví dụ: ước tính giá một ngôi nhà hoặc khoảng thời gian một bệnh nhân nằm viện)
- Cây phân loại (Classification tree): nếu y là một biến phân loại như: giới tính (nam hay nữ), kết quả của một trận đấu (thắng hay thua).
Ưu điểm cây quyết định
So với các phương pháp khai phá dữ liệu khác, cây quyết định là phương pháp có một số ưu điểm:
- Cây quyết định dễ hiểu. Người ta có thể hiểu mô hình cây quyết định sau khi được giải thích ngắn.
- Việc chuẩn bị dữ liệu cho một cây quyết định là cơ bản hoặc không cần thiết. Các kỹ thuật khác thường đòi hỏi chuẩn hóa dữ liệu, cần tạo các biến phụ (dummy variable) và loại bỏ các giá trị rỗng.
- Cây quyết định có thể xử lý cả dữ liệu có giá trị bằng số và dữ liệu có giá trị là tên thể loại. Các kỹ thuật khác thường chuyên để phân tích các bộ dữ liệu chỉ gồm một loại biến. Chẳng hạn, các luật quan hệ chỉ có thể dùng cho các biến tên, trong khi mạng nơ-ron chỉ có thể dùng cho các biến có giá trị bằng số.
- Cây quyết định là một mô hình hộp trắng. Nếu có thể quan sát một tình huống cho trước trong một mô hình, thì có thể dễ dàng giải thích điều kiện đó bằng logic Boolean. Mạng nơ-ron là một ví dụ về mô hình hộp đen, do lời giải thích cho kết quả quá phức tạp để có thể hiểu được.
- Có thể thẩm định một mô hình bằng các kiểm tra thống kê. Điều này làm cho ta có thể tin tưởng vào mô hình.
- Cây quyết định có thể xử lý tốt một lượng dữ liệu lớn trong thời gian ngắn. Có thể dùng máy tính cá nhân để phân tích các lượng dữ liệu lớn trong một thời gian đủ ngắn để cho phép các nhà chiến lược đưa ra quyết định dựa trên phân tích của cây quyết định.
CÁC THUẬT TOÁN
Thuật toán CLS
Thuật toán này được Holland và Hint giới thiệu trong Concept learning System (CLS) vào những năm 50 của thế kỷ 20[4]. Thuật toán CLS được thiết kế theo chiến lược chia để trị từ trên xuống. Nó gồm các bước sau:
1. Tạo một nút T, nút này gồm tất cả các mẫu của tập huấn luyện.
2. Nếu tất cả các mẫu trong T có thuộc tính quyết định mang giá trị “yes” (hay thuộc cùng một lớp), thì gán nhãn cho nút T là “yes” và dừng lại. T lúc này là nút lá.
3. Nếu tất cả các mẫu trong T có thuộc tính quyết định mang giá trị “no” (hay thuộc cùng một lớp), thì gán nhãn cho nút T là “no” và dừng lại. T lúc này là nút lá.
4. Trường hợp ngược lại các mẫu của tập huấn luyện thuộc cả hai lớp “yes” và “no” thì:
- Chọn một thuộc tính X trong tập thuộc tính của tập mẫu dữ liệu , X có các giá trị vi,v2, …vn.
- Chia tập mẫu trong T thành các tập con T1, T2,..,Tn. chia theo giá trị của X.
- Tạo n nút con T; (i=1,2.n) với nút cha là nút T.
- Tạo các nhánh nối từ nút T đến các nút T; (i=1,2.n) là các thuộc tính của X.
5. Thực hiện lặp cho các nút con T:(i =1,2..n) và quay lại bước 2.
Thuật toán ID3
Thuật toán ID3 được phát biểu bởi Quinlan (trường đại học Syney, Australia) và được công bố vào cuối thập niên 70 của thế kỷ 20[4]. Sau đó, thuật toán ID3 được giới thiệu và trình bày trong mục Induction on decision trees, machine learning năm 1986. ID3 được xem như là một cải tiến của CLS với khả năng lựa chọn thuộc tính tốt nhất để tiếp tục triển khai cây tại mỗi bước. ID3 xây dựng cây quyết định từ trên- xuống (top -down).
Thuật toán C4.5
Thuật toán C4.5 do Quinlan phát triển vào năm 1996 [1] [2] [3] [4]. Thuật toán C4.5 là một thuật toán được cải tiến từ thuật toán ID3 với việc cho phép xử lý trên tập dữ liệu có các thuộc tính số (numeric atributes) và và làm việc được với tập dữ liệu bị thiếu và bị nhiễu. Nó thực hiện phân lớp tập mẫu dữ liệu theo chiến lược ưu tiên theo chiều sâu (Depth – First).
Một số cài tiến của thuật toán C4.5:
- Làm việc với thuộc tính đa trị
- Làm việc với dữ liệu bị thiếu
Thuật toán SLIQ[5]
Thuật toán SLIQ (Supervised Learning In Quest) được gọi là thuật toán phân lớp leo thang nhanh. Thuật toán này có thể áp dụng cho cả hai kiểu thuộc liên tục và thuộc tính rời rạc[4][5].
Thuật toán này có sử dụng kỹ thuật tiền xử lý phân loại(Pre sorting) trước khi xây dựng cây, do đó giải quyết được vấn đề bộ nhớ cho thuật toán ID3.
Thuật toán SLIQ có sử dụng giải thuật cắt tỉa cây hữu hiệu.
Thuật toán SLIQ có thể phân lớp rất hiệu quả đối với các tập dữ liệu lớn và không phụ thuộc vào số lượng lớp, số lượng thuộc tính và số lượng mẫu trong tập dữ liệu.
VÍ DỤ MINH HỌA
Phát biểu bài toán
David là quản lý của một câu lạc bộ đánh golf nổi tiếng. Anh ta đang có rắc rối chuyện các thành viên đến hay không đến. Có ngày ai cũng muốn chơi golf nhưng số nhân viên câu lạc bộ lại không đủ phục vụ. Có hôm, không hiểu vì lý do gì mà chẳng ai đến chơi, và câu lạc bộ lại thừa nhân viên.
Mục tiêu của David là tối ưu hóa số nhân viên phục vụ mỗi ngày bằng cách dựa theo thông tin dự báo thời tiết để đoán xem khi nào người ta sẽ đến chơi golf. Để thực hiện điều đó, anh cần hiểu được tại sao khách hàng quyết định chơi và tìm hiểu xem có cách giải thích nào cho việc đó hay không.
Vậy là trong hai tuần, anh ta thu thập thông tin về: Trời (outlook) (nắng (sunny), nhiều mây (overcast) hoặc mưa (raining). Nhiệt độ (temperature) bằng độ F. Độ ẩm (humidity). Có gió mạnh (windy) hay không. Và là số người đến chơi golf vào hôm đó. David thu được một bộ dữ liệu gồm 14 dòng và 5 cột.
Bảng 2.1: Dữ liệu chơi golf
| Ngày | Quang cảnh | Nhiệt độ | Độ ẩm | Gió | Chơi Tennis |
| D1 | Nắng | Nóng | Cao | Nhẹ | Không |
| D2 | Nắng | Nóng | Cao | Mạnh | Không |
| D3 | Âm u | Nóng | Cao | Nhẹ | Có |
| D4 | Mưa | Ấm áp | Cao | Nhẹ | Có |
| D5 | Mưa | Mát | TB | Nhẹ | Có |
| D6 | Mưa | Mát | TB | Mạnh | Không |
| D7 | Âm u | Mát | TB | Mạnh | Có |
| D8 | Nắng | Ấm áp | Cao | Nhẹ | Không |
| D9 | Nắng | Mát | TB | Nhẹ | Có |
| D10 | Mưa | Ấm áp | TB | Nhẹ | Có |
| D11 | Nắng | Ấm áp | TB | Mạnh | Có |
| D12 | Âm u | Ấm áp | Cao | Mạnh | Có |
| D13 | Âm u | Nóng | TB | Nhẹ | Có |
| D14 | Mưa | Ấm áp | Cao | Mạnh | Không |
Sau đó, để giải quyết bài toán của David, người ta đã đưa ra một mô hình cây quyết định.
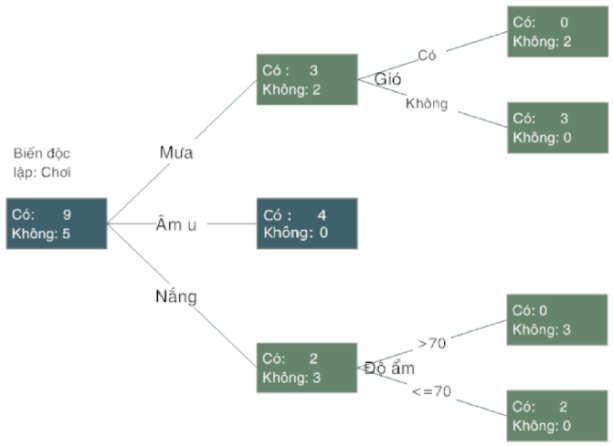
Hình 2.2: Mô hình cây quyết định chơi golf
Cây quyết định là một mô hình dữ liệu mã hóa phân bố của nhãn lớp theo các thuộc tính dùng để dự đoán. Đây là một đồ thị có hướng phi chu trình dưới dạng một cây. Nút gốc (nút nằm trên đỉnh) đại diện cho toàn bộ dữ liệu. Thuật toán cây phân loại phát hiện ra rằng cách tốt nhất để giải thích biến phụ thuộc, play (chơi), là sử dụng biến Outlook. Phân loại theo các giá trị của biến Outlook, ta có ba nhóm khác nhau: Nhóm người chơi golf khi trời nắng, nhóm chơi khi trời nhiều mây, và nhóm chơi khi trời mưa.
Minh họa xây dựng cây quyết định
Cây quyết định cần tìm bằng cách minh họa
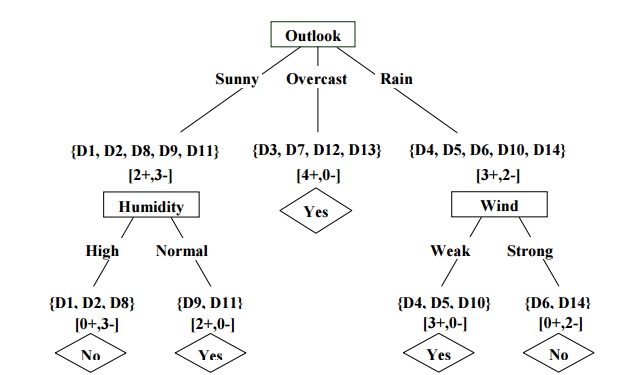
Hình 2.7: Cây quyết định cần tìm.
KẾT CHƯƠNG
Chương 2 trình bày tổng quan về khai phá dữ liệu bằng hình thức phân lớp với cây quyết định, bao gồm khái niệm phân lớp và ưu điểm cây quyết định. Nghiên cứu thuật toán khai phá dữ liệu, trong đó nghiên cứu sâu về thuật toán ID3 làm tiền đề cho việc nghiên cứu thực nghiệm, đồng thời đưa ra những khó khăn trong quá trình sử dụng thuật toán ID3. Các khó khăn này cần phải được giải quyết trong khai phá dữ liệu. Trong chương sau, luận văn sẽ trình bày một ứng dụng cụ thể mà ngân hàng có thể áp dụng để phân loại khách hàng của mình, căn cứ vào kết quả ngân hàng sẽ có thêm sự hỗ trợ để quyết định có cho khách hàng vay vốn hay không.
ỨNG DỤNG CÂY QUYẾT ĐỊNH TRONG PHÂN LOẠI KHÁCH HÀNG VAY VỐN TẠI NGÂN HÀNG VIETINBANK CHI NHÁNH KON TUM
GIỚI THIỆU QUY TRÌNH TÍN DỤNG TẠI NGÂN HÀNG VIETINBANK CHI NHÁNH KON TUM
Tổng quan về quy trình tín dụng:
Khái niệm:
Quy trình tín dụng là bảng tổng hợp mô tả công việc của ngân hàng từ khi tiếp nhận hồ sơ vay vốn của khách hàng cho đến khi quyết định cho vay, giải ngân, thu nợ và thanh lý hợp đồng tín dụng.
Vai trò:
Việc xác lập một quy trình tín dụng và không ngừng hoàn thiện nó đặc biệt quan trọng đối với một ngân hàng thương mại:
- Về mặt hiệu quả, một quy trình tín dụng hợp lý sẽ giúp cho ngân hàng nâng cao chất lượng tín dụng và giảm thiểu rủi ro tín đụng.
- Về mặt quản lý, quy trình tín dụng có tác dụng:
- Làm cơ sở cho việc phân định quyền, trách nhiệm cho từng bộ phận trong hoạt động tín dụng.
- Làm cơ sở để thiết lập các hồ sơ, thủ tục vay vốn về mặt hành chính.
- Chỉ rõ mối quan hệ giữa các bộ phận liên quan trong hoạt động tín dụng.
Nội dung cơ bản của quy trình tín dụng:
Quy trình tín dụng của ngân hàng công thương Việt Nam – Vietinbank
Bước 1: Phỏng vấn và hướng dẫn khách hàng lập hồ sơ đề nghị vay vốn
- Phỏng vấn và trao đổi với khách hàng:
- Hướng dẫn khách hàng lập, tiếp nhận và đối chiếu hồ sơ đề nghị vay vốn
Sau khi trao đổi thông tin với khách hàng, nếu khách hàng chấp thuận, CBTD hướng dẫn khách hàng lập và gửi hồ sơ vay vốn.
Lưu ý: Hồ sơ phải do khách hàng vay vốn lập, cán bộ tín dụng khôn2 được lập thay.
Bước 2. Thẩm định mức độ đáp ứng các điều kiện vay vốn
Bước 3. Xác định số tiền, phương thức, lãi suất, thời hạn cho vay; định kỳ hạn nợ và xem xét điều kiện thanh toán
Bước 4. Lập tờ trình thẩm định cho vay, soạn thảo hợp đồng tín dụng, hợp đồng bảo đảm tiền vay và trình phê duyệt cho vay
Bước 5. Công chứng hoặc chứng thực ; đăng ký gia dịch bảo đảm; giao nhận giấy tờ của tài sản bảo đảm và hoặc tài sản bảo đảm.
Bước 6. Giải ngân, thu nợ gốc, lãi và kiểm tra, giám sát món vay
Bước 7. Cơ cấu lại thời hạn trả nợ
Bước 8. Giải chấp tài sản bảo đảm, thanh lý hợp đồng tín dụng, hợp đồng tài sản bảo đảm.
THUẬT TOÁN ID3
Giới thiệu về thuật toán ID3
Giải thuật quy nạp cây ID3 (gọi tắt là ID3) là một giải thuật học đơn giản nhưng tỏ ra thành công trong nhiều lĩnh vực. ID3 là một giải thuật hay vì cách biểu diễn tri thức học được của nó, tiếp cận của nó trong việc quản lý tính phức tạp, heuristic của nó dùng cho việc chọn lựa các khái niệm ứng viên, và tiềm năng của nó đối với việc xử lý dữ liệu nhiễu.
ID3 biểu diễn các khái niệm (concept) ở dạng các cây quyết định (decision tree). Biểu diễn này cho phép chúng ta xác định phân loại của một đối tượng bằng cách kiểm tra các giá trị của nó trên một số thuộc tính nào đó.
Như vậy, nhiệm vụ của giải thuật ID3 là học cây quyết định từ một tập các mẫu rèn luyện (training example) hay còn gọi là dữ liệu rèn luyện (training data). Hay nói khác hơn, giải thuật có:
 Đầu vào: Một tập hợp các mẫu. Mỗi mẫu bao gồm các thuộc tính mô tả một tình huống, hay một đối tượng nào đó, và một giá trị phân loại của nó.
 Đầu ra: Cây quyết định có khả năng phân loại đúng đắn các mẫu trong tập dữ liệu rèn luyện, và hy vọng là phân loại đúng cho cả các mẫu chưa gặp trong tương lai.
Giải thuật ID3 xây dựng cây quyết định từ trên xuống
ID3 xây dựng cây quyết định (cây QĐ) theo cách từ trên xuống. Lưu ý rằng đối với bất kỳ thuộc tính nào, chúng ta cũng có thể phân vùng tập hợp các mẫu rèn luyện thành những tập con tách rời, mà ở đó mọi mẫu trong một phân vùng (partition) có một giá trị chung cho thuộc tính đó. ID3 chọn một thuộc tính để kiểm tra tại nút hiện tại của cây và dùng cách kiểm tra này để phân vùng tập hợp các mẫu; thuật toán khi đó xây dựng theo cách đệ quy một cây con cho từng phân vùng. Việc này tiếp tục cho đến khi mọi thành viên của phân vùng đều nằm trong cùng một lớp; lớp đó trở thành nút lá của cây.
Thuộc tính dùng để phân loại cây quyết định
Quinlan (1983) là người đầu tiên đề xuất việc sử dụng lý thuyết thông tin để tạo ra các cây quyết định và công trình của ông là cơ sở cho phần trình bày ở đây. Lý thuyết thông tin của Shannon (1948) cung cấp khái niệm entropy để đo tính thuần nhất (hay ngược lại là độ pha trộn) của một tập hợp.
- Entropy đo tính thuần nhất của tập huấn luyện
- Lượng thông tin thu được đo mức độ giảm entropy mong đợi
- Tìm kiếm không gian giả thuyết trong ID3
- Đánh giá hiệu suất của cây quyết định
- Chuyển cây về các luật
- Ứng dụng của giải thuật ID3
. ỨNG DỤNG ID3 ĐỂ PHÂN LỚP ĐỐI TƯỢNG KHÁCH HÀNG VAY VỐN
Quy trình thực nghiệm
Mô hình thực nghiệm của chương trình hệ thống quyết định cho vay vốn ngân hàng.
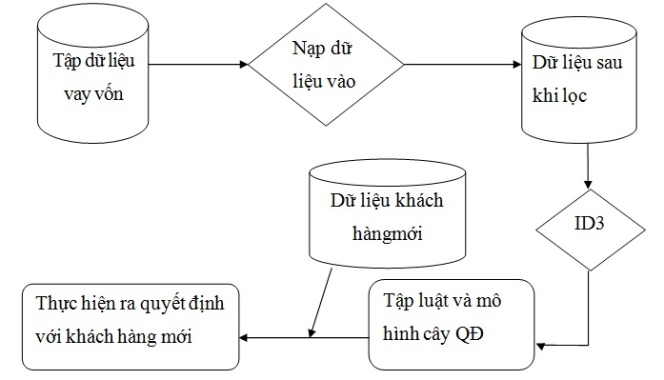
Hình 3.6: Quy trình thực nghiệm của quy trình quyết định cho vay vốn
– Quy trình thực nghiệm với 621 mẫu dữ liệu được nạp vào hệ thống dưới dạng file excel Dulieuvayvon.xlsx.
– Sau khi dữ liệu được nạp vào hệ thống ta thực hiện lọc những dữ liệu trùng và những mẫu dữ liệu mâu thuẫn với nhau ta được bộ dữ liệu sau khi lọc.
– Sau đó dùng thuật toán ID3 thực hiện đối với bộ dữ liệu sau khi lọc bỏ nhũng mẫu trùng và mâu thuẫn ta được mô hình cây quyết định ID3 và tập luật sinh ra từ bộ dữ liệu.
– Nạp bộ dữ liệu khách hàng mới chưa phân loại cho vay vốn vào hệ thống. Từ tập luật và mô hình cây quyết định ID3 tập dữ liệu khách hàng mới sẽ được phân lớp dữ liệu là có được cho vay vốn hay không.
Giới thiệu bài toán
Chúng ta đang sống trong thế giới thừa thông tin thiếu tri thức – đó là nhận định của nhiều người trong thời đại bùng nổ thông tin hiện nay.
Sử dụng phương pháp khai phá tri thức từ dữ liệu để dự đoán rủi ro tín dụng là một phương pháp mới nhằm nâng cao chất lượng tín dụng của Ngân hàng.
Rủi ro tín dụng có thể được hiểu là nguy cơ một người đi vay không thể trả được gốc và/hoặc lãi đúng thời hạn quy định.
Trong phạm vi luận văn này tôi đã tập trung nghiên cứu đối với công tác tín dụng tiêu dùng của khách hàng với tập mẫu dữ liệu bao gồm 621 mẫu dữ liệu khách hàng vay vốn tại ngân hàng Vietinbank chi nhánh Kon Tum. Dựa vào tập mẫu Dulieuvayvon.xlsx sẽ xây dựng mô hình cây quyết định, từ cây quyết định rút ra các luật quyết định. Dựa vào các luật quyết định đó ta sẽ phân lớp được tập dữ liệu mới (dữ liệu về khách hàng xin vay tiêu dùng, nhưng chưa được phân lớp) và tập dữ liệu sau khi được phân lớp sẽ hỗ trợ cho các cán bộ tín dụng ra quyết định cho khách hàng vay hay không.
Đặc tả dữ liệu
Luận văn sử dụng tập dữ liệu: Dulieuvayvon .xlsx gồm 621 đối tượng với 10 thuộc tính điều kiện và thuộc tính quyết định “result” quyết định một khách hàng là được vay và không được vay.
Các thuộc tính và giá trị của các thuộc tính của tập dữ liệu Dulieuvayvon được mô tả trong bảng sau:
| Thứ tự | Thuộc tính | Giá trị | Ý nghĩa |
|---|---|---|---|
| 1 | Tuoi | Tre, TrungNien, Gia | Trẻ, Trung niên, già |
| 2 | Gioitinh | Nam, Nu | Nam, Nữ |
| 3 | Hokhau | NongThon, ThiTran, NgoaiO, ThanhPho | Nông thôn, Thị trấn, Ngoại ô, Thành phố |
| 4 | Thunhap | Thap,Trungbinh, Cao | Thấp, trung bình, cao |
| 5 | Kethon | Co, Khong | Có, không |
| 6 | SoCon | Khongcon, Motcon, Haicon, Bacon | Không con, Một con, Hai con, Ba con |
| 7 | XeOto | Co, Khong | Có, không |
| 8 | TaikhoaTietkiem | Co, Khong | Có, không |
| 9 | TaikhoanHientai | Co, Khong | Có, không |
| 10 | TaisanThechap | Co, Khong | Có, không |
| 11 | RESULT(Chovay) | True, false | Có (True), Không (False) |
Bảng 3.7: Bảng thuộc tính tập dữ liệu ngân hàng
Cài đặt thuật toán
Ứng dụng này được viết trong môi trường Visual Studio 2010, viết bằng ngôn ngữ lập trình C#. Ứng dụng này tập trung vào xây dựng và đưa ra các quyết định và các tập luật của thuật toán ID3. Từ các cây quyết định hay các luật quyết định rút ra từ cây quyết định sẽ hỗ trợ cho các cán bộ tín dụng trong ngân hàng quyết định cho khách hàng được vay hay không.
- Cài đặt ứng dụng
Chương trình:
- Đầu vào: Dữ liệu đầu vào dạng file Excel Dulieuvayvon.xlsx là tập các dữ liệu mẫu chứa các thông tin được sử dụng trong mô tả bài toán.
- Đầu ra: Đầu ra của chương trình là tập các luật dự đoán sắp xếp phân loại khách hàng vay vốn, mô hình cây quyết định ID3 với tập dữ liệu mẫu đầu vào và ứng dụng phân loại khách hàng vay vốn cho cán bộ tín dụng.
Chương trình gồm các mô đun chính như sau:
- Đọc dữ liệu đầu vào từ file excel( Tập dữ liệu mẫu gồm 621 đối tượng Dulieuvayvon.xlsx)
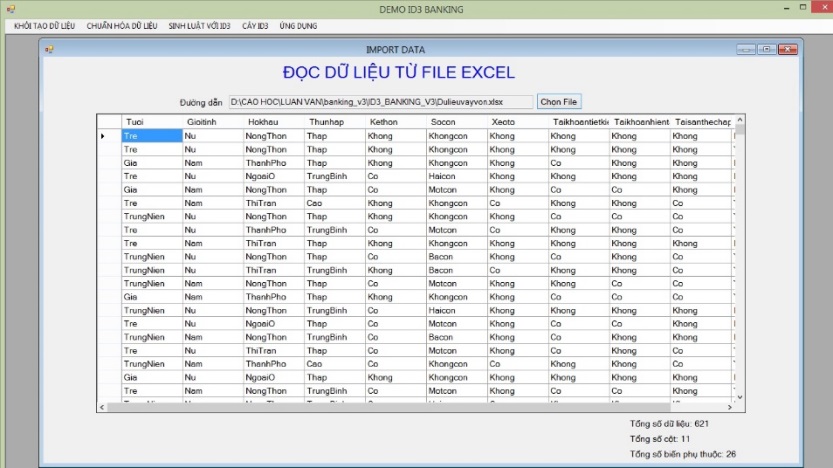
Hình 3.9: Thực hiện nạp dữ liệu vào hệ thống
- Kiểm tra dữ liệu
- Chuẩn hóa dữ liệu( Lọc ra và loại những dữ liệu trùng, những bộ dữ liệu mâu thuẫn)
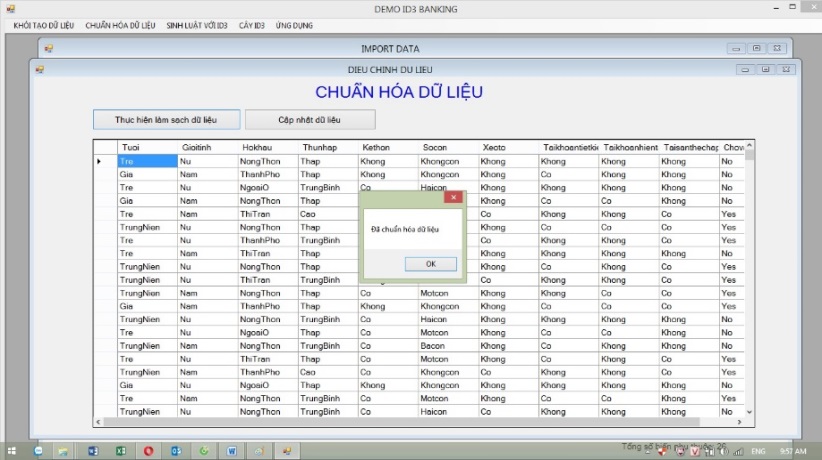
Hình 3.10: Chuẩn hóa dữ liệu đầu vào
- Tạo luật được sinh ra từ tập dữ liệu mẫu sau khi đã chuẩn hóa
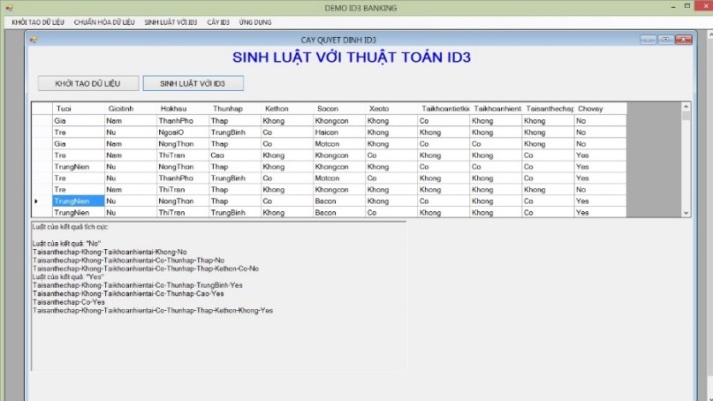
Hình 3.13: Kết quả các luật được sinh ra với thuật toán ID3
- Tạo cây ID3 với bộ dữ liệu Dulieuvayvon.xlsx( Gồm 621 đối tượng)
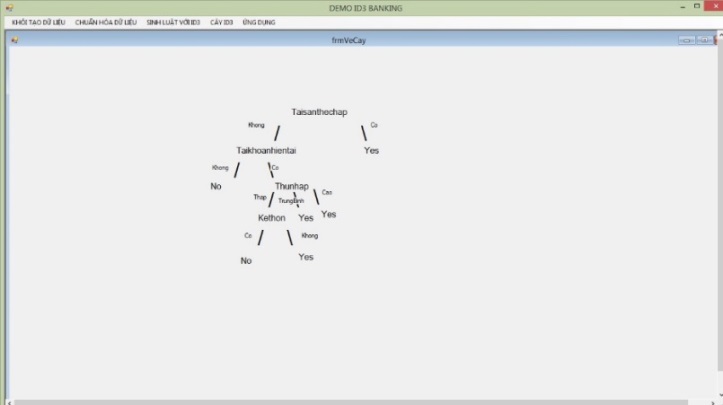
Hình 3.14: Kết quả cây ID3 với bộ dữ liệu Dulieuvayvon.xlsx
- Ứng dụng ID3 quyết định cho vay vốn
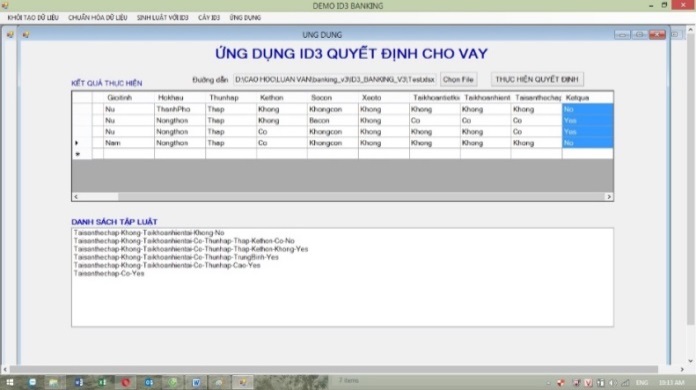
Hình 3.17: Kết quả sau khi thực hiện quyết định có cho khách hàng mới vay hay không
KẾT CHƯƠNG
Trong chương này đã phát biểu bài toán để kiểm chứng các thuật toán xây dựng cây quyết định ở chương 2 trên bộ dữ liệu mẫu Dulieuvayvon.xlsx. Đồng thời cài đặt chương trình hỗ trợ cán bộ tín dụng ra quyết định vay vốn. Dựa vào mô hình cây quyết định (các luật quyết định) đã được xây dựng, phân lớp các mẫu dữ liệu khách hàng mới.
Khai phá dữ liệu là một lĩnh vực đã, đang và luôn luôn thu hút các nhà nghiên cứu bởi nó là một lĩnh vực cho phép phát hiện tri thức trong cơ sở dữ liệu khổng lồ bằng các phương thức thông minh. Nghiên cứu lĩnh vực này đòi hỏi người nghiên cứu phải biết tổng hợp các kết quả nghiên cứu ở nhiều lĩnh vực của khoa học máy tính và việc ứng dụng nó trong từng nhiệm vụ của khai phá dữ liệu.
Qua hai năm học tập, tìm tòi, nghiên cứu, đặc biệt là trong khoảng thời gian làm luận văn, tác giả đã hoàn thiện luận văn với các mục tiêu đặt ra ban đầu. Cụ thể luận văn đã đạt được những kết quả sau:
1. KẾT QUẢ ĐẠT ĐƯỢC
- Trình bày các kiến thức cơ bản về khai phá dữ liệu; hệ thống hóa các kiến thức cơ bản của lý thuyết tập thô được áp dụng để xây dựng cây quyết định.
- Giới thiệu phương pháp tổng quát xây dựng cây quyết định, và trình bày bốn thuật toán xây dựng cây quyết định CLS, ID3, C4.5, FLIQ[5] và một số mẫu minh họa cho các phương pháp xây dựng cây quyết định cũng được trình bày.
- Cài đặt bằng Visual Studio thuật toán xây dựng cây quyết định ID3 trên cơ sở dữ liệu mẫu Dulieuvayvon hỗ trợ cán bộ tín dụng ra quyết định vay vốn.
2. HẠN CHẾ CỦA ĐỀ TÀI
- Dữ liệu còn hạn chế, mang tính chất nghiên cứu demo.
- Giao diện chương trình chưa thân thiện.
- Chưa so sánh, đánh giá được với các phương pháp khác.
3. KIẾN NGHỊ VÀ HƯỚNG PHÁT TRIỂN
Qua quá trình học tập, nghiên cứu tác giả không những tích lũy được thêm các kiến thức mà còn nâng cao được khả năng lập trình, phát triển ứng dụng. Tác giả nhận thấy luận văn đã giải quyết tốt các nội dung, yêu cầu nghiên cứu đặt ra, có các ví dụ minh họa cụ thể. Song do thời gian có hạn nên luận văn vẫn còn tồn tại một số thiếu sót, một số vấn đề mà tác giả còn phải tiếp tục nghiên cứu, tìm hiểu.
Cần bổ sung thêm dữ liệu cho tập huấn luyện để mô hình cây quyết định có độ tin cậy cao hơn và hoạt động hiệu quả hơn. Tiếp tục phát triển hoàn thiện theo hướng trở thành phần mềm khai phá dữ liệu trong tín dụng tiêu dùng nhằm hỗ trợ cho cán bộ tín dụng đưa ra quyết định cho khách hàng vay hay không.
Tìm hiểu nhu cầu thực tế để từ đó cải tiến chương trình, cài đặt lại bài toán theo các thuật toán đã nghiên cứu để làm việc tốt hơn với các cơ sở dữ liệu lớn và có thể có được sản phẩm trên thị trường.
Hướng phát triển của đề tài là:
Về lý thuyết:
- Cần tiếp tục nghiên cứu các thuật toán khai phá dữ liệu bằng cây quyết định dựa vào tâp thô như: thuật toán ADTCCC (dựa vào CORE và đại lượng đóng góp phân lớp của thuộc tính), thuật toán ADTNDA (dựa vào độ phụ thuộc mới của thuộc tính), …
- Nghiên cứu các phương pháp xây dựng cây quyết định trên hệ thống thông tin không đầy đủ, dữ liệu liên tục và không chắc chắn.
Về chương trình demo:
- Cần bổ sung thêm dữ liệu cho tập training để mô hình cây quyết định có độ tin cậy cao hơn và hoạt động hiệu quả hơn.
- Cần tiếp tục phát triển hoàn thiện theo hướng trở thành phần mềm khai phá dữ liệu trong tín dụng tiêu dùng nhằm hỗ trợ cho cán bộ tín dụng đưa ra quyết định cho khách hàng vay hay không.
- Tìm hiểu nhu cầu thực tế để từ đó cải tiến chương trình, cài đặt lại bài toán theo các thuật toán đã nghiên cứu để làm việc tốt hơn với các cơ sở dữ liệu lớn và có thể có được sản phẩm trên thị trường.
E:\DỮ LIỆU COP CỦA CHỊ YẾN\DAI HOC DA NANG\HE THONG THONG TIN\FIEL TAM\PHAM DINH BON


