
Tìm Hiểu Và Xây Dựng Ứng Dụng Số Hóa Rút Trích Thông Tin Danh Thiếp Trên Hệ Điều Hành Android
Tính cấp thiết của đề tài.
Danh thiếp là một tấm thẻ nhỏ chứa các thông tin liên lạc như: tên, số điện thoại, email,… của các cá nhân, tổ chức hay các cơ quan, doanh nghiệp. Nhằm để lại thông tin liên lạc cho đối tác, khách hàng. Thế nhưng việc quản lý, tìm kiếm và sử dụng danh thiếp gặp rất nhiều khó khăn khi một người nhận được quá nhiều danh thiếp. Vấn đề đặt ra là liệu có giải pháp nào tốt hơn nhằm khắc phục khó khăn trên, trong khi với công nghệ hiện có cho phép chúng ta giải quyết vấn đề này, chụp ảnh và nhận dạng ký tự trong ảnh.
Qua tìm hiểu thì em được biết về nhận dạng ký tự quang học (tiếng Anh: Optical Character Recognition, viết tắt là OCR) là quá trình rút trích ký tự trong ảnh cho ra dưới dạng văn bản để có thể lưu trữ, chỉnh sửa và tìm kiếm được. Tuy nhiên các công nghệ OCR hiện có thường nhận dạng trực tiếp trên máy tính. Điều này chỉ thực hiện được khi ở nhà, ở cơ quan nơi có máy tính bên cạnh. Vấn đề đặt ra là phải có một hệ thống phần cứng và phần mềm nhỏ gọn, di động nhưng vẫn thực hiện được chức năng chụp ảnh, OCR trên ảnh đã chụp và lưu thông tin vào.
Ngày nay, công nghệ điện thoại di động đang ngày càng phát triển. Nhu cầu sử dụng điện thoại Smartphone ngày càng tăng và gần như được phổ biến rộng rải ở mọi độ tuổi, mọi tầng lớp với đầy đủ chức năng chụp ảnh, lưu trữ dữ liệu…như vậy vấn đề còn lại chỉ là ứng dụng chạy được trên thiết bị đó và có thể OCR được.
Mục tiêu nghiên cứu.
Với mong muốn tìm hiểu về lĩnh vực, công nghệ OCR và từ đó xây dựng hệ thống OCR chạy trên Smartphone mà cụ thể là hệ điều hành Android, có thể chụp ảnh, nhận dạng rút trích thông tin danh thiếp từ ảnh đã chụp và lưu vào danh bạ điện thoại. Đó cũng chính là lý do khiến tôi chọn đề tài “Tìm Hiểu Và Xây Dựng Ứng Dụng Số Hóa Rút Trích Thông Tin Danh Thiếp Trên Hệ Điều Hành Android” làm hướng nghiên cứu cho luận văn.
Phương pháp nghiên cứu.
Về mặt lý thuyết.
– Nghiên cứu tổng quan về lĩnh vực OCR, các thành phần trong một hệ thống OCR cơ bản, các công trình nghiên cứu cũng như một số công nghệ phân mềm OCR tiêu biểu.
– Nghiên cứu tổng quan về Tesseract OCR.
– Nghiên cứu tổng quan về hệ điều hành Android.
Về mặt thực hành.
– Nghiên cứu xây dựng ứng dụng OCR. Sử dụng Android Studio để tạo ra ứng dụng chạy trên điện thoại Android có chức năng chụp ảnh, rút trích thông tin như: tên, số điện thoại, email, địa chỉ từ ảnh đã chụp và lưu thông tin đó vào danh bạ điện thoại.
4. Bố cục luận văn.
Ngoài phần mở đầu giới thiệu về tính cấp thiết của đề tài, mục tiêu nghiên cứu, phương pháp nghiên cứu và phần kết luận tóm tắt những kết quả chính đã đạt được cũng như đưa ra nhận xét đánh giá hướng phát triển của đề tài. Thì bố cục của luận văn gồm 3 chương chính:
Chương 1: Tổng Quan Về OCR
Chương 2: Tổng Quan Về Tesseract OCR Và Hệ Điều Hành Android
Chương 3: Xây Dựng Ứng Dụng Số Hóa Rút Trích Thông Tin Danh Thiếp Trên Hệ Điều Hành Android
CHƯƠNG 1
TỔNG QUAN VỀ OCR
1.1 Giới thiệu về OCR.
OCR (tiếng Anh: Optical Character Recognition) là lĩnh vực nhận dạng ký tự quang học. Kỹ thuật này cho phép máy tính tự động nhận dạng ký tự trong ảnh thông qua cơ chế quang học. Đầu vào của bộ nhận dạng ký tự quang học là một ảnh scan các tài liệu, sách … chứa các ký tự và đầu ra là văn bản đó dưới dạng chuỗi ký tự có thể chỉnh sửa và tìm kiếm được.
Vào những năm đầu của thế kỷ 20, các nhà khoa học đã quan tâm nghiên cứu trong lĩnh vực OCR. Tuy nhiên kết quả lúc bấy giờ vẫn còn rất hạn chế.
Năm 1929, đã xuất hiện chiếc máy nhận dạng chữ số. Đến những năm đầu của thập niên 1950, chiếc máy đầu tiên có khả năng chuyển tài liệu bản in thành ngôn ngữ trên máy tính được phát minh bởi David Shepard. Năm 1955 sản phẩm từ công nghệ OCR được đưa ra thương mại hóa lần đầu tiên. Tuy nhiên mãi đến năm 1978, phiên bản OCR cho máy tính mới được ra đời. Ứng dụng đầu tiên của nó là dùng để tải những văn bản luật và tin tức lên cơ sở dữ liệu trực tuyến. Ngày nay, công nghệ OCR được kết hợp với máy scan tốc độ cao và những thuật toán máy tính phức hợp đã làm gia tăng tốc độ xử lý cũng như sự chính xác của dữ liệu. Những công nghệ OCR hiện tại đều có thể nhận dạng hầu hết các font chữ với độ chính xác cao, một số còn hỗ trợ khả năng kết xuất ra những đoạn văn bản có định dạng gần giống hoàn toàn với bản gốc.
Hiện nay nhiều ứng dụng OCR được đưa ra sử dụng dưới dạng offline trên máy tính hoặc tích hợp và chạy online trên các thiết bị OCR chuyên dụng. Đặc biệt các hệ thống OCR thời gian thực được chú trọng phát triển. Các kỹ thuật nhận dạng hiện nay kết hợp rất hiệu quả với một số phương pháp luận trong lĩnh vực học máy (machine learning) như mạng nơ ron, SVM (supper vector machines), xử lý ngôn ngữ tự nhiên. Mặt dù được phát triển mạnh mẽ, nhưng kết quả nghiên cứu trong lĩnh vực OCR cũng gặp phải những trở ngại nhất định. OCR chưa bao giờ đạt tới tỷ lệ chính xác 100% trong nhiều trường hợp. Các yếu tố ảnh hưởng nhiều đến kết quả OCR như chất lượng ảnh đầu vào, bố cục ảnh, loại font chữ, các ký tự đặc biệt (ví dụ như công thức toán học), các chữ viết phức tạp như chữ Trung Quốc và một số yếu tố khác.
1.2 Các thành phần cơ bản trong hệ thống OCR.
Một hệ thống OCR thông thường gồm một số bước cơ bản sau:
1.2.1 Thu nhận ảnh.
Thu nhận ảnh là bước đầu tiên trong quy trình của hệ thống OCR. Hình ảnh tài liệu bên ngoài được thu nhận qua các thiết bị thu ảnh như camera, máy ảnh, máy scan và được số hóa để biến đổi tín hiệu tương tự thành tín hiệu rời rạc (lấy mẫu) và lưu vào máy tính dưới các định dạng file ảnh. Độ phân giải của ảnh ảnh hưởng rất lớn đến kết quả OCR. Ảnh thu được có độ phân giải 300dpi không phải là chuẩn chính thức quy ước cho các ảnh đầu vào của các hệ thống OCR nhưng cũng có thể xem như một chuẩn tương đối tốt. Tuy nhiên không phải ảnh có độ phân giải càng cao thì kết quả OCR càng tốt. Do đó các hệ thống OCR khuyến nghị các bức ảnh đầu vào nên có độ phân giải từ 200dpi – 400dpi.
1.2.2 Tiền xử lý ảnh.
Đây là giai đoạn rất quan trọng, ảnh hưởng trực tiếp độ chính xác của các thuật toán nhận dạng, các bức ảnh thu được, chất lượng thường không tốt như ý muốn, có thể do một số nguyên nhân như: chất lượng của thiết bị thu ảnh (độ phân giải thấp), yếu tố nguồn sáng, tài liệu ảnh thực tế bị suy biến, tư thế chụp không đúng…Do vậy, ảnh trước khi đưa vào nhận dạng cần phải qua một số bước xử lý nhằm tăng cường chất lượng ảnh, làm nổi bật một số đặc tính của ảnh, đặc biệt tăng độ tương phản giữa foreground (đối tượng trong ảnh) và background (nền ảnh). Một số công việc chủ yếu trong bước này bao gồm nhị phân hóa ảnh, dò hướng đúng và chỉnh độ nghiêng ảnh, giảm nhiễu để loại bỏ những thành phần không cần thiết, hiệu chỉnh kích thước ảnh về kích thước chuẩn, lọc nhiễu, làm trơn biên chữ, làm đầy chữ, làm mảnh chữ.

1.2.3 Phân tích bố cục.
Đây cũng là một trong những bước đặc biệt quan trọng trong hệ thống OCR. Nó là quá trình chia nhỏ ảnh văn bản thành các khối thuần nhất, có nghĩa là các khối này chỉ chứa một loại thông tin, hoặc là text, hoặc là ảnh hoặc là bảng…Trong nhiều trường hợp, độ chính xác của quá trình phân tích bố cục văn bản làm ảnh hưởng rất nhiều đến độ chính xác của hệ thống OCR cũng như giảm thời gian thực hiện.
Hiện nay có hai hướng tiếp cận chính trong quá trình tách khối văn bản là: thuật toán top-down. Thuật toán này bắt đầu thực hiện từ toàn bộ văn bản sẽ tìm ra các khối, sau đó sẽ dựa trên các khối để tìm ra dòng, từ rồi ký tự. Cách tiếp cận thứ hai là bottom-up ngược lại với cách tiếp cận đầu tiên, cách này đi từ các thành phần liên thông nhỏ để tìm ra các ký tự, rồi tìm đến các từ sau đó là các dòng, từ các dòng này sẽ tìm được các khối.
Một số phương pháp áp dụng trong phân tích bố cục tài liệu ảnh như: S.Chen sử dụng phương pháp phân vùng văn bản theo hướng bottom-up để tách khối, A.Antonacopouslos thì đưa ra phương pháp theo hướng top-down, Ths Nguyễn Đức Thành cũng đã đưa ra một phương pháp phân vùng văn bản theo hướng top-down…
1.2.4 Tách dòng, từ và nhận dạng ký tự.
Thuật toán xác định bố cục văn bản ảnh thực chất là chia ảnh văn bản ra thành nhiều khối, mỗi khối sẽ đặc trưng cho một vùng văn bản. Sau đó các thuật toán tìm dòng sẽ chạy trên các khối này để chia khối này thành các dòng (text-line). Rồi mỗi dòng có thể được chia thành một hoặc nhiều từ tương tự mỗi từ được chia thành nhiều ký tự.
Thước đo khã năng của hệ thống OCR chính là độ chính xác của việc nhận dạng từ, do vậy thuật toán nhận dạng ký tự thường quyết định sự thành công hay thất bại của hệ thống. Dưới đây là một số phương pháp nhận dạng ký tự thông dụng nhất.
– Phương pháp đối sánh mẫu hay còn gọi là phương pháp so sánh ma trận: phân lớp dựa trên việc so sánh ảnh ký tự đầu vào với một tập hợp các ảnh ký tự mẫu chuẩn. Sau khi tiến hành so sánh với tất cả các mẫu, ký tự sẽ được gán với mẫu giống nhất. Phương pháp này áp dụng đặc biệt hiệu quả đối với các văn bản chữ in (printed-document) với font chữ đã được xác định trước.
– Phương pháp phân lớp dựa vào cấu trúc ký tự: sử dụng các đặc điểm mang tính cấu trúc và các luật quyết định như nét ký tự, các điểm giao…
– Phương pháp nhận dạng ký tự bằng mạng nơron: thường được áp dụng khi những phương pháp khác tỏ ra không hiệu quả. Ưu điểm của mạng nơron là khã năng trích chọn đặc trưng và phân lớp tự động thông qua quá trình học mẫu (hay còn gọi là quá trình huấn luyện). Việc học của mạng có thể được tiến hành với sự giám sát và tham gia của con người hoặc cũng có thể tự động hoàn toàn. Yêu cầu của phương pháp này là phải thu thập được số lượng mẫu học đủ lớn để đảm bảo cho việc hội tụ của mạng.
1.2.5 Hậu xử lý.
Kết quả nhận dạng ít nhiều vẫn xuất hiện lỗi, lỗi có thể do con người đánh máy trước khi nhận dạng, lỗi do nhận dạng, đặc biệt là nhận dạng văn bản tiếng việt có độ phức tạp cao do sự kết hợp giữa chữ cái Latinh và hệ thống dấu (sắc, huyền, hỏi, ngã, nặng), chưa kể các ký tự rất giống nhau chúng chỉ khác nhau về dấu như: a, ă, â, à, á, ã, ả, ạ…, lỗi phân đoạn như: cld, rnm , lỗi do nhầm lẫn hình dạng như: ec, 2Z, o0 , lỗi do nhiễu…,nên rất khó phân biệt do vậy xác suất nhận dạng sai cũng sẽ rất cao.
Cuối bước nhận dạng ký tự, các hệ thống OCR thường cài đặt cơ chế hậu xử lý dựa theo đặc thù ngôn ngữ và dựa trên ngữ cảnh. Cơ chế hậu xử lý có thể là các bộ kiểm tra lỗi chính tả, lỗi cú pháp hoặc người đọc sẽ duyệt lại và sửa bằng tay.
1.3 Một số thư viện mã nguồn mở và phần mềm OCR phổ biến hiện nay.
Lĩnh vực OCR hiện nay được rất nhiều cá nhân, tổ chức quan tâm nghiên cứu, nhiều công nghệ OCR ra đời và được ứng dụng rộng rãi trong nhiều lĩnh vực liên quan đến nhận dạng. Dưới đây liệt kê danh sách một số phần mềm OCR tiêu biểu:
– Phần mềm ABBYY FineReader (Proprietary).
– Omnipage (Proprietary).
– Image To OCR Converter.
– Tesseract OCR.
– GOCR.
– Phần mềm VnDOCR.
– Simple OCR.
– VietOCR.
– JavaOCR.
1.4 Phương pháp áp dụng OCR trong luận văn.
Luận văn tập trung vào việc sử dụng kỹ thuật nhận dạng ký tự quang học áp dụng trên điện thoại Android để thực hiện việc số hóa rút trích thông tin danh thiếp qua camera của điện thoại. Sau đây là các phương pháp có thể áp dụng kỹ thuật nhận dạng ký tự quang học:
– Nghiên cứu và tự xây dựng một bộ nhận dạng ký tự quang học.
– Sử dụng các bộ nhận dạng ký tự quang học trực tiếp trên web thông qua môi trường mạng.
– Sử dụng các bộ thư viện nhận dạng ký tự quang học có sẵn.
Từ những phương pháp có thể áp dụng kỹ thuật nhận dạng ký tự quang học nêu trên. Tôi thấy việc sử dụng bộ thư viện nhận dạng ký tự quang học có sẵn là khả thi nhất vừa tiết kiệm được thời gian xây dựng ứng dụng, ứng dụng có thể nhận dạng ở mọi lúc mọi nơi mà không nhất thiết phải cần điện thoại kết nối mạng.
1.5 So sánh và lựa chọn thư viện để thực hiện quá trình nhận dạng ký tự.
Trong các thư viện nhận dạng ký tự quang học thì bộ nhận dạng Tesseract OCR nổi trội nhất với các ưu điểm sau:
– Có lịch sử phát triển lâu dài và mang lại độ chính xác cao ngay từ khi mới ra đời.
– Khả năng mở rộng và tùy biến cao đồng thời được Google tài trợ và đông đảo các nhà phát triển tham gia đóng góp cho Tesseract.
– Phiên bản được cập nhật thường xuyên, hỗ trợ ngày càng nhiều ngôn ngữ, có khả năng huấn luyện trên các ngôn ngữ mới và nhiều loại font chữ khác nhau.
– Một số phần mềm OCR hiện nay đều sử dụng bộ nhận dạng này cho việc nhận dạng ký tự nên Tesseract đã trở nên phổ biến hơn, đồng thời khả năng hỗ trợ trên nhiều môi trường, nền tảng khác nhau từ máy tính cho đến các thiết bị di động.
– Điều quan trọng nhất là có nhiều thông tin và tài liệu tham khảo về bộ nhận dạng này, việc này giúp cho việc nghiên cứu được thuận lợi hơn.
Chính vì các ưu điểm nêu trên mà trong luận văn này tôi sẽ sử dụng bộ nhận dạng ký tự quang học mã nguồn mở Tesseract OCR để thực hiện quá trình nhận dạng ký tự trong chương trình của mình.
CHƯƠNG 2
TỔNG QUAN VỀ TESSERACT OCR VÀ HỆ ĐIỀU HÀNH ANDROID
2.1 Tổng quan về Tesseract OCR.
Lúc mới khởi động thì Tesseract là một dự án nghiên cứu luận án tiến sĩ tại phòng thí nghiệm HP ở Bristol và nó được thúc đẩy mạnh mẽ hơn để có thể cho ra một sản phẩm phần mềm khả thi đi kèm với dòng sản phẩm máy quét để bàn của HP. Nhưng dự án này đã thất bại ngay từ ban đầu vì nó chỉ làm việc hiệu quả trên các tài liệu in có chất lượng cực tốt. Sau đó dự án đã được khởi động trở lại tại phòng thí nghiệm Bristol với mục đích nghiên cứu về cách thức nén và tối ưu hóa mã nguồn. Dự án tập trung nhiều hơn vào việc cải thiện tính hiệu quả làm việc của Tesseract dựa trên độ chính xác đã có và đã được hoàn tất vào cuối năm 1994, vào năm 1995 bộ Tesseract được gửi đi tham dự hội nghị UNLV thường niên về độ chính xác của OCR, Tesseract nằm trong nhóm ba bộ nhận dạng OCR đứng đầu về độ chính xác vượt trội hơn hẳn so với các phần mềm OCR lúc bấy giờ.
Vào năm 2005, HP chính thức công bố chuyển Tesseract thành mã nguồn mở, dưới sự tài trợ của Google. Cho đến nay Tesseract vẫn được nhiều nhà phát triển tiếp tục hoàn thiện nâng cao độ chính xác để tiến tới tỉ lệ 100%, và hỗ trợ nhận dạng trên nhiều ngôn ngữ khác nhau.
2.1.2 Kiến trúc hoạt động.
Đầu vào của bộ nhận dạng Tesseract là ảnh màu hoặc ảnh mức xám, ảnh này sẽ được chuyển đến bộ phận phân tích ngưỡng thích nghi ( adaptive thresholding ) để cho ra ảnh nhị phân. Ban đầu, bộ nhận dạng Tesseract được thiết kế làm việc trên ảnh nhị phân, nhưng sau này nó được cải tiến để nhận dạng ảnh màu và ảnh mức xám cho nên cần có bước phân ngưỡng thích nghi này để chuyển ảnh màu hay ảnh mức xám sang ảnh nhị phân.
Sau khi ảnh gốc được chuyển thành ảnh nhị phân, nó sẽ phân tích các thành phần liên thông. Ở giai đoạn này nó sẽ tạo ra các đường bao quanh các ký tự trong các vùng văn bản. Rồi sau đó sẽ nhóm các đường bao quanh các ký tự lại với nhau thành các dòng văn bản.
Cuối cùng là nhận dạng từ, công đoạn này sẽ được chia thành hai giai đoạn. Giai đoạn đầu sẽ là nhận dạng các từ theo lượt. Các từ thỏa yêu cầu trong giai đoạn này sẽ được chuyển sang bộ phân loại thích ứng (adaptive classifier) để làm dữ liệu huấn luyện. Chính nhờ đó mà bộ phân loại thích ứng sẽ có khả năng nhận dạng được chính xác hơn ở phần sau. Vì bộ phân loại thích ứng đã học được các thông tin từ giai đoạn đầu nên bộ nhận dạng cần có giai đoạn thứ 2. Giai đoạn thứ 2 này sẽ quét hết toàn bộ trang, các từ không được nhận dạng chính xác ở giai đoạn đầu sẽ được nhận dạng lại lần nữa. Cuối cùng bộ nhận dạng sẽ tổng hợp lại các thông tin ở trên và cho ra kết quả nhận dạng hoàn chỉnh.
2.1.3 Phân ngưỡng thích nghi.
Là việc xác định một giá trị T nào đó mà người ta dựa vào đó để xác định giá trị của điểm ảnh sẽ được gán bằng 0 hay là 1 ( giá trị 0 sẽ là giá trị ứng với những điểm đen trên ảnh và giá trị 1 sẽ là giá trị ứng với những điểm trắng trên ảnh). Việc này nhằm mục đích nhị phân hóa ảnh đầu vào (ảnh màu hoặc ảnh mức xám…), cho nên việc tính toán chọn ngưỡng T phù hợp có ý nghĩa rất lớn trong việc nhị phân hóa ảnh.
Hiện nay có rất nhiều thuật toán nhị phân hóa ảnh với ngưỡng thích nghi như: thuật toán Otsu, thuật toán đối xứng, thuật toán tam giác…
Trong bộ nhận dạng Tesseract, hàm phân ngưỡng thích nghi là hàm ThresholdToIMAGE() để thực hiện việc nhị phân hóa ảnh đầu vào được viết trong tập tin mã nguồn /ccmain/thresholder.cpp.
2.1.4 Phân tích thành phần liên thông.
Bộ nhận dạng Tesseract dùng các hàm như SegmentPage () trong tập tin mã nguồn /textord/pagesegment.cpp và find_components () trong tập tin mã nguồn /textord/tordmain.cpp để tiến hành phân tích thành phần liên thông. Kết quả của quá trình này các dãy màu (còn gọi là blobs) hình chữ nhật cao quanh các ký tự.
2.1.5 Tìm dòng văn bản và từ.
Giai đoạn tìm dòng này được thực hiện để có thể nhận dạng một trang văn bản bị nghiêng, xiên. Do đó nó sẽ giảm được việc mất thông tin ảnh. Các thành phần quan trọng trong tiến trình xử lý đó là lọc ra được các khối ký tự và tạo dựng dòng văn bản.
Khi các dòng văn bản được xác định, các đường cơ sở được điều chỉnh cho chính xác hơn. Đây là bước rất cần thiết đối với một hệ thống nhận dạng OCR, cho phép Tesseract có thể xử lý các trang có đường cơ bản bị cong, vênh. Các đường cơ bản được điều chỉnh bằng việc phân hoạch các ô ký tự thành các nhóm, với độ giản cách liên tiếp hợp lý so với đường cơ bản gốc ban đầu.
Tất cả quá trình này được Tesseract thực hiện thông qua hàm make_single_row () trong tập tin mã nguồn /textord/makerow.cpp và make_single_word () trong tập tin mã nguồn /textord/wordseg.cpp.
Kết thúc bước này, các ký tự được sắp xếp vào các khối từ, lúc này vẫn còn ở dạng ảnh, được nhận biết nhờ các thông tin về tọa độ và kích thước của hình chữ nhật bao quanh và các từ được sắp xếp vào các khối hàng.
2.1.6 Nhận dạng từ.
Từ các khối từ đã tìm được ở bước trên, Tesseract sử dụng hàm recog_all_words () trong tập tin mã nguồn /ccmain/control.cpp để bắt đầu quá trình nhận dạng. Kết thúc quá trình này, các khối từ được nhận dạng thành các từ dưới dạng chuỗi ký tự.
Lý do quá trình nhận dạng từ trải qua 2 lần nhận dạng là vì Tesseract sử dụng bộ nhận dạng thích ứng (adaptive classifier). Nghĩa là quá trình nhận dạng bộ phân lớp vẫn được huấn luyện với dữ liệu huấn luyện là kết quả nhận dạng của các từ đã được nhận dạng.
Lần nhận dạng thứ nhất, Tesseract sử dụng hàm classify_word_pass1() trong tập tin mã nguồn /ccmain/control.cpp để thực hiện nhận dạng từng từ một. Trong quá trình nhận dạng này, các từ đạt yêu cầu được chuyển tới bộ phân lớp thích ứng (adaptmatch.cpp) như là dữ liệu huấn luyện. Bộ phân lớp thích ứng sau đó sẽ nhận dạng văn bản chính xác hơn ở phần sau của trang.
Vì bộ phân lớp thích ứng học được các thông tin hữu ích sau khi nhận dạng ở lần 1 nên Tesseract cần nhận dạng từ lần 2 để nhận dạng lại toàn bộ trang cũng như nhận dạng lại các từ chưa được nhận dạng tốt ở lần 1. Tesseract nhận dạng từ lần 2 thông qua hàm classify_word_pass2() trong tập tin mã nguồn /ccmain/control.cpp.
2.1.7 Huấn luyện dữ liệu trên Tessract OCR.
Tesseract ban đầu được thiết kế để nhận dạng các từ tiếng Anh trên ngôn ngữ hệ Latinh. Sau này, nhờ sự cố gắng của nhiều nhà phát triển mà các phiên bản của Tesseract đã có thể nhận diện các ngôn ngữ khác ngoài hệ Latinh như tiếng Trung, tiếng Nhật và tương thích với các ký tự trong bảng mã UTF-8. Việc nhận dạng các ngôn ngữ mới trên Tesseract có thể thực hiện được nhờ vào việc huấn luyện dữ liệu. Từ phiên bản 3.0[1] trở đi, Tesseract đã có thể hỗ trợ thêm nhiều dạng ngôn ngữ mới và mở rộng thêm việc huấn luyện theo font chữ.
Để huấn luyện dữ liệu trên Tesseract (hoặc ngôn ngữ mới) thì ta cần một tập các tập tin dữ liệu chứa trong thư mục tessdata, sau đó kết hợp các tập tin này thành tập tin duy nhất. Các tập tin có trong thư mục tessdata có quy tắc đặt tên theo dạng: tên_ngôn_ngữ.tên_tập_tin.
Các tập tin cần thiết cho việc huấn luyện dữ liệu sẽ được phát sinh khi ta sử dụng công cụ có sẵn để thực hiện quá trình huấn luyện.
2.2 Tổng quan về hệ điều hành Android.
2.2.1 Giới thiệu.
Android là hệ điều hành dựa trên nền tảng Linux dùng cho các thiết bị di động bao gồm điện thoại thông minh, máy tính bảng. Được phát triển ban đầu tại công ty liên hợp Android sau đó công ty này được Google mua lại vào năm 2005 và biến Android thành một hệ điều hành mã nguồn mở trên các thiết bị di động.
Android chính thức ra mắt vào 2007 cùng với sự ra đời của liên minh thiết bị cầm tay mở OHA (Open Handset Alliance). Liên minh OHA là một tổ chức bao gồm khoảng hơn 78 công ty viễn thông, di động và phần cứng như Goolge, Sony Ericsson, Samsung, Nvidia, Qualcomm… Mục tiêu của hội này là phát triển các chuẩn mở chung cho thiết bị di động trong tương lai. Và Android là sản phẩm chủ lực của hãng. Mã nguồn của Android là mã nguồn mở và được công bố dưới dạng giấy phép Apache.
Theo công ty nghiên cứu thị trường Canalys đã ước tính trong quý 2 năm 2009. Android có 2,8% thị phần điện thoại thông minh được bán ra trên toàn cầu. Đến quý 4 năm 2010 con số này tăng lên 33% thị phần, trở thành nền tảng điện thoại thông minh bán chạy hàng đầu. Đến quý 3 năm 2011 ước tính rằng hơn một nữa 52,5% thị trường điện thoại thông minh thuộc về Android. Đến quý 3 năm 2012 Android chiếm 75% thị phần điện thoại thông minh toàn cầu vực qua cả IOS.
Với các nhà phát triển ứng dụng (developers), việc hệ điều hành Android được sử dụng phổ biến cũng như mã nguồn mở đồng nghĩa với việc họ có thể thỏa mái phát triển ứng dụng trên nền Android, ứng dụng đó có thể chạy được ngay trên nhiều dòng máy của các hãng khác nhau. Họ ít phải quan tâm là đang phát triển cho điện thoại nào, phiên bản bao nhiêu vì nền tảng Android chung cho nhiều dòng máy, máy ảo Java đã chiệu trách nhiệm thực thi những ứng dụng cho phù hợp với mỗi dòng máy mà nó đang chạy. Một số hãng sản xuất điện thoại sử dụng hệ điều hành Android tiêu biểu như: SAMSUNG, HTC, SONY, OPPO…
Hệ điều hành Android được chia ra thành các tầng, từ dưới lên trên gồm có: Linux Kernel, tiếp theo là Libraries và Android Runtime, trên nữa là Application Framework và trên cùng là Applications.
2.2.2.1 Tầng hạt nhân Linux (Linux kernel).
Được phát triển dựa trên nhân Linux (Linux kernel 2.6) và được cải tiến nhiều để phù hợp với tính chất của những thiết bị di động như hạn chế về bộ vi xử lý, dung lượng bộ nhớ. Tầng này bao gồm những dịch vụ hệ thống chủ yếu như quản lý bộ nhớ (memory management), giao tiếp với phần cứng (driver model), thực hiện bảo mật (sercurity), quản lý tiến trình (process). Tầng này đóng vai trò là tầng trung gian kết nối phần cứng thiết bị và ngăn xếp phần mềm ở tầng trên.
2.2.2.2 Tầng Libraries và Android Runtime.
Tầng này bao gồm hai thành phần đó là Libraries và Android Runtime.
– Libraries: Android có hệ thống các thư viện C/C++ được sử dụng nhiều trong các thành phần khác nhau của hệ điều hành. Một số các thư viện C/C++ chính trong Android: Thư viện hệ thống, thư viện Media, thư viện web thư viện SQLite.
– Android runtime: Phần này chứa các thư viện mà một chương trình viết bằng ngôn ngữ Java có thể hoạt động. Phần này có hai bộ phận tương tự như mô hình chạy Java trên máy tính. Thứ nhất là lõi (Core Library) chứa các lớp như JAVA IO, Collections, File Access. Thứ hai là máy ảo Java (Dalvik Virtual Machine) Máy ảo thực thi các tập tin định dạng dex. Mỗi ứng dụng được chạy trên một tiến trình riêng của máy ảo Dalvik.
2.2.2.3 Tầng Application Framework.
Tầng này cung cấp một nền tảng phát triển ứng dụng mở. Các nhà phát triển ứng dụng dễ dàng sử dụng framework này để tạo ra các ứng dụng một cách nhanh chóng. Framework được viết bằng ngôn ngữ Java, có khả năng sử dụng chung để tiết kiệm tài nguyên. Nền tảng mở này giúp cho các hãng sản xuất điện thoại có thể tùy biến để phù hợp với cấu hình điện thoại của hãng, đồng thời giúp cho người lập trình có thể sử dụng các hàm API ở tầng trên mà không cần phải hiểu rõ cấu trúc bên dưới. Tầng này bao gồm một tập các thành phần và dịch vụ cho phép các nhà phát triển phần mềm có thể gọi các hàm hỗ trợ sẵn qua giao diện lập trình ứng dụng API (Application Programming Interface) .
2.2.2.4 Tầng Applications.
Đây là tầng cao nhất trong hệ điều hành Android, giao tiếp với người sử dụng thông qua các ứng dụng được cài đặt như gọi điện (phone), quản lý danh bạ (contacts), trinh duyết web, game…
2.2.3 Android software development kit (SDK).
Bộ công cụ phát triển ứng dụng cho Android hay còn gọi là Android SDK giúp cho các nhà phát triển phần mềm gỡ lỗi và kiểm thử ứng dụng mà không cần phải có thiết bị thật cũng như cung cấp cho các lập trình viện những thư viện, công cụ và những tài liệu liện quan để có thể phát triển ứng dụng trên nền tảng Android.
CHƯƠNG 3
XÂY DỰNG ỨNG DỤNG SỐ HÓA RÚT TRÍCH THÔNG TIN
DANH THIẾP TRÊN HỆ ĐIỀU HÀNH ANDROID
3.1 Mô tả bài toán.
Như đã trình bày ở phần mở đầu, danh thiếp là một tấm thẻ nhỏ chứa các thông tin liên lạc của một cá nhân hay một tổ chức. Vấn đề nảy sinh khi một người nhận được quá nhiều danh thiếp. Điều này sẽ gây khó khăn trong việc quản lý và tìm kiếm thông tin liên lạc từ đống danh thiếp này.
Do vậy, luận văn này hướng tới việc tìm hiểu về công nghệ OCR, bộ nhận dạng mã nguồn mở Tessract để ứng dụng vào việc giải quyết bài toán nhận dạng và xây dựng một ứng dụng giúp người dùng quản lý danh thiếp một cách hiệu quả hơn. Ứng dụng cung cấp chức năng cho người dùng chụp ảnh danh thiếp, các thông tin trên danh thiếp như Tên, số điện thoại, email, địa chỉ sẽ được tự động rút trích và lưu vào danh bạ điện thoại.
3.2 Yêu cầu đặc ra cho hệ thống.
Ứng dụng số hóa rút trích thông tin danh thiếp được xây dựng nhằm thực hiện các chức năng sau:
– Người dùng sẽ sử dụng camera điện thoại để chụp ảnh hoặc lấy ảnh từ thư viện ảnh, sau đó nhận dạng các ký tự trong ảnh và rút trích thông tin danh thiếp trên ảnh từ quá trình nhận dạng. hiển thị thông tin rút trích này lên cho người dùng xem và kiểm tra độ chính xác của thông tin sau đó sẽ quyết định có lưu vào danh bạ hay không.
– Nếu ứng dụng phát hiện tên cần được lưu vào trùng với tên trong danh bạ đã có thì cần thông báo cho người dùng. Nếu người dùng vẫn tiếp tục lưu thì hai tên này sẽ được ghép với nhau thành một trong danh bạ điện thoại.
– Ứng dụng tập trung chủ yếu nhận dạng danh thiếp tiếng việt.
– Các danh thiếp sau khi được rút trích thông tin sẽ được lưu vào danh bạ điện thoại Android. Cho nên ứng dụng cần cho phép người dùng thực hiện các thao tác như: tìm kiếm, chỉnh sửa, xóa và thực hiện việc liên lạc từ điện thoại.
3.3 Sơ đồ tổng quát của hệ thống.
Quy trình hoạt động của hệ thống gồm các bước như sau:
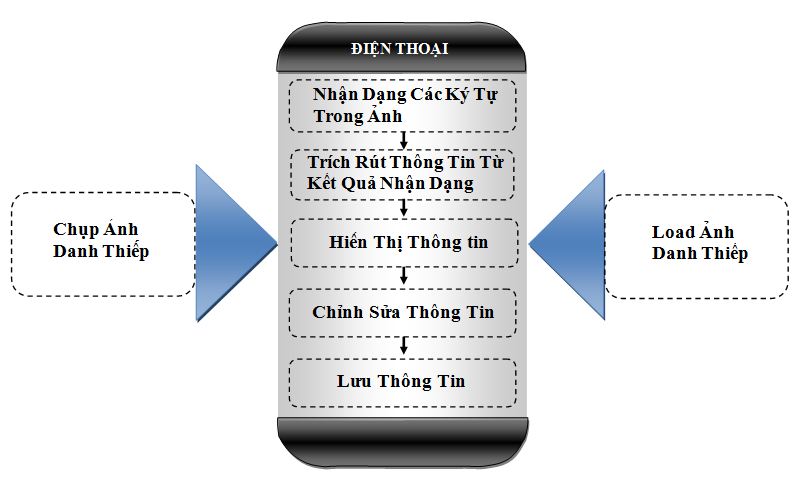
Hình 3.1: Sơ đồ tổng quát của hệ thống.
3.4 Các thuật toán sử dụng để rút trích thông tin.
3.4.1 Thuật toán rút trích số điện thoại.
Sau khi thực hiện việc nhận dạng các ký tự trong ảnh. Hệ thống sẽ tiến hành đọc các dòng thông tin từ kết quả nhận dạng để tách số điện thoại và phân ra làm hai loại,số điện thoại cố định và số điện thoại di động nếu có.
Thuật toán rút trích số điện thoại sử dụng trong luận văn như sau:
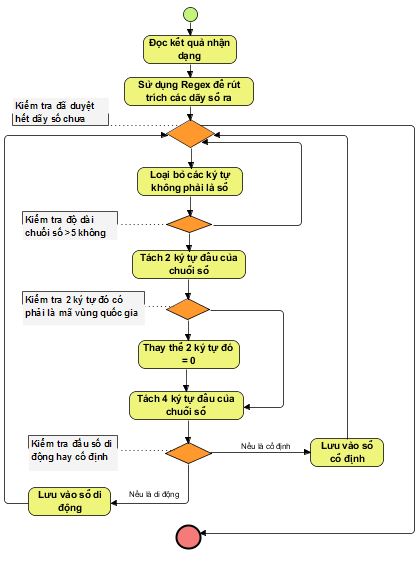
Hình 3.4: thuật toán rút trích số điện thoại
3.4.2 Thuật toán rút trích địa chỉ.
Trên danh thiếp, các dòng chứa thông tin về địa chỉ thường bắt đầu bằng các tiền tố như: ĐC hay Địa chỉ….Cho nên chúng ta có thể dựa vào các tiền tố đó để rút trích thông tin địa chỉ từ kết quả thu được trong quá trình OCR. Quá trình này tôi cũng sử dụng Regular Expression để kiểm tra tiền tố. Tuy nhiên, vẫn có một số danh thiếp không chứa các tiền tố đó, hay trong quá trình nhận dạng các tiền tố này không được nhận dạng đúng. Vì vậy chúng ta cần phải tiến hành kiểm tra xem các dòng thông tin đó có chứa tên định danh của các tỉnh thành trong nước không, nếu có thì chúng ta có thể xác định được đó là dòng chứa thông tin về địa chỉ.
3.4.3 Thuật toán rút trích họ tên người.
Thông thường họ tên người việt khi viết cũng như nói bao gồm có 3 thành phần chính đó là: họ + tên đệm + tên chính dùng để phân biệt người này với người khác, họ này với họ khác. Họ người Việt hay người Kinh chủ yếu là đơn âm, họ người Việt hiện nay tập trung gần 90% dân số trong 14 họ chính.
Trong khi đó, tên đệm và tên chính của người Việt thường rất đa dạng và phong phú nên sẽ rất khó khăn trong việc rút trích thông tin họ và tên. Chính vì thế để thực hiện việc rút trích thông tin họ tên người, chúng ta sẽ dựa vào các họ của người Việt để thực hiện.
3.4.4 Thuật toán rút trích thông tin email.
Cũng tương tự như thuật toán rút trích thông tin số điện thoại được trình bày ở mục (3.4.1). Thông thường, địa chỉ email bao gồm ba phần chính có dạng như sau: Tên_định_dạng_thêm tên_email@tên_miền .
Phần tên_định_dạng_thêm: Đây là một dạng tên để cho người đọc có thể dễ dàng nhận ra người gửi hay nơi gửi.
Phần tên_email: Đây là phần xác định hộp thư. Thông thường, cho dễ nhớ, phần này hay mang tên của người chủ ghép với một vài ký tự đặc biệt. Phần tên này thường do người đăng ký hộp thư điện tử đặt ra. Phần này còn được gọi là phần tên địa phương.
Phần tên_miền: Đây là tên miền của nơi cung cấp dịch vụ thư điện tử, ngay sau phần tên_email bắt đầu bằng chữ “@” nối liền sau đó là tên miền.
Từ cấu trúc chung của một địa chỉ email như trên chúng ta sẽ dể dàng rút trích địa chỉ email thông qua thuật toán Regular Expression.
3.5 Một số giao diện của ứng dụng số hóa rút trích thông tin danh thiếp.
3.5.1 Giao diện chính.
Khi người dùng mở ứng dụng OCR DANH THIẾP lên màn hình chính được hiển thị. Từ giao diện chương trình người dùng có thể tùy chọn các chức năng như chụp ảnh danh thiếp, chọn ảnh từ thư viện ảnh trong điện thoại, mở danh bạ điện thoại.
3.5.2 Màn hình chụp ảnh danh thiếp.
Từ giao diện chính của ứng dụng, người dùng chọn chức năng chụp ảnh.
Tại đây người dùng có thể mở đèn flash nếu thấy ánh sáng bên ngoài không được tốt. Sau đó người dùng chọn chụp ảnh thì ứng dụng sẽ tự động chuyển sang màn hình nhận dạng và rút trích thông tin danh thiếp.
3.5.3 Màn hình rút trích thông tin danh thiếp.
Sau khi chụp ảnh, hệ thống sẽ tiến hành nhận dạng các ký tự trong ảnh. Từ kết quả nhận dạng đó chương trích sẽ rút trích thông tin như tên, số điện thoại, địa chỉ, email và hiển thị thông tin lên giao diện chương trình.
Tại đây người dùng có thể chỉnh sửa thông tin, thêm thông tin và chọn chức năng lưu vào danh bạ hoặc hủy.
3.5.4 Màn hình quản lý danh bạ.
Sau khi người dùng chọn chức năng danh bạ, giao diện quản lý danh bạ được hiển thị. Ở màn hình này, người dùng có thể thực hiện các chức năng như tìm kiếm, sửa đổi thông tin, gọi điện, nhăn tin và gửi mail…
3.6 Thực nghiệm và đánh giá kết quả.
Luận văn đã xây dựng thành công ứng dụng số hóa rút trích thông tin danh thiếp trên hệ điều hành Android. Việc thực nghiệm và đánh giá kết quả sử dụng tập ảnh chụp danh thiếp từ camera điện thoại Samsung Galaxy Grand Prime G530 chạy hệ điều hành Android 4.4 (kitkat).
Việc thực nghiệm được tiến hành trên 50 ảnh danh thiếp. Trong đó, đa phần các danh thiếp này là các danh thiếp củ đã qua sử dụng, được chụp cẩn thận trong điều kiện ánh sáng bình thường. Trong tổng số 50 danh thiếp thì có 33 danh thiếp nhận dạng và rút trích thông tin được.
Từ kết quả trong quá trình thực nghiệm, tôi đã thống kê được tỷ lệ nhận dạng đúng ký tự cũng như rút trích thông tin từ ứng dụng, bằng cách tính tổng số ký tự nhận dạng đúng trên tổng số ký tự. Sau đây là bảng thống kê tỷ lệ nhận dạng đúng ký tự.
Bảng 3.2: Thống kê kết quả thực nghiệm
| Tổng số ký tự | Nhận dạng đúng ký tự | Tỷ lệ trung bình | |
| Tên hiển thị | 150 | 134 | 89,33% |
| Số điện thoại | 580 | 559 | 96,37% |
| Địa chỉ | 456 | 396 | 86,84% |
| 264 | 218 | 82,57% |
Với bảng thống kê kết quả OCR (Bảng 3.2) , tuy có thể không đúng khi thực nghiệm trên một số ảnh khác nhưng vẫn có thể đưa ra các nhận xét sau:
– Ứng dụng có thể nhận dạng và rút trích thông tin, trên danh thiếp có nhiều Font chữ khác nhau, cở chữ cũng như kiểu chữ khác nhau. Đặc biệt, font Arial và Times New Roman thường cho ra kết quả tốt hơn.
– Kết quả nhận dạng và rút trích thông tin như tên và số điện thoại thường tốt hơn địa chỉ và email. Có thể do trên danh thiếp, các phần này thường được thiết kế với cở chữ nhỏ nhất.
– Ứng dụng chỉ có thể rút trích thông tin tốt trên các ảnh chụp không bị nghiêng, không rung tay trong điều kiện ánh sáng tốt.
– Trong quá trình nhận dạng thường xuất hiện các ký tự lạ như (“). Một phần có thể do các danh thiếp bị bẩn và một phần do logo, các hình ảnh được thiết kế trên danh thiếp được nhận dạng nhầm.
– Một số lỗi khi nhận dạng thường gặp như nhầm lẩn giữa chữ hoa và chữ thường, sót dấu (ví dụ: VÕ HOÀI ĐỨC => vỏ HOÀI ĐỨC, NGUYỄN => NGUYEN).
– Một số danh thiếp được thiết kế theo phong cách riêng, đa dạng về hình ảnh màu sắc, kiểu dáng cũng như nội dung thông tin được trình bày không theo quy tắc nhất định. Điều này gây ra khó khăn không nhỏ trong quá trình nhận dạng và rút trích thông tin.
– Danh thiếp có nhiều nội dung và hình ảnh thì thời gian nhận dạng và rút trích thông tin thường lâu hơn. Trung bình thời gian nhận dạng và rút trích thông tin khoảng 15(giây).
– Cũng qua kết quả thực nghiệm ở trên cho thấy Tesseract OCR là bộ nhận dạng ký tự quang học tốt. Do sự đóng góp liện tục của cộng đồng quan tâm đến lĩnh vực nhận dạng cho nên các phiên bản cũng như dữ liệu tập huấn được cập nhật thường xuyên.
KẾT LUẬN
- Kết quả đạt được.
Hiện nay, lĩnh vực OCR với mục đích chính là rút trích các ký tự trong ảnh và lưu thành dạng text, được ứng dụng một cách rộng rãi trong nhiều lĩnh vực đời sống. Nhiều hệ thống OCR được xây dựng và đưa ra dưới dạng sản phẩm thương mại hoặc miễn phí, thậm chí dưới dạng mã nguồn mở. Với mong muốn tìm hiểu lĩnh vực OCR và góp phần trong việc bổ sung vào kho ứng dụng OCR một sản phẩm mới, Luận văn đã đi vào nghiên cứu “Xây dựng ứng dụng số hóa rút trích thông tin danh thiếp trên hệ đều hành Android” sử dụng công nghệ nhận dạng mã nguồn mở Tesseract OCR.
Trong quá trình làm luận văn, ngoài việc tạo ra được một sản phẩm OCR thực tế, bản thân đã có cơ hội tìm tòi và hiểu biết nhiều hơn, rộng hơn về lĩnh vực OCR và lập trình ứng dụng. Bản thân đã hiểu biết được nguyên lý hoạt động của một hệ thống OCR cơ bản, tổng quan về công nghệ Tesseract OCR, hệ điều hành Android. Ngoài ra, bản thân được nâng cao về kỹ năng lập trình trên điện thoại di động.
Trong khuôn khổ của luận văn, tôi đã trình bày một cách tổng quan về lĩnh vực OCR cũng như một số vấn đề liên quan. Do mục đích của luận văn là nghiên cứu và xây dựng ứng dụng số hóa rút trính thông tin danh thiếp sử dụng mã nguồn mở cũng như một số công nghệ tiên tiến hiện có nên không đi sâu vào lý thuyết từng phương pháp, từng thuật toán cụ thể được sử dụng trong các bước của một hệ thống OCR.
- Hạn chế.
Giải pháp xây dựng ứng dụng số hóa rút trích thông tin danh thiếp trên hệ điều hành Android đã giải quyết được một số vấn đề về chức năng của hệ thống. Tuy nhiên, hệ thống vẩn còn một số khuyết điểm như:
– Độ chính xác trong quá trình nhận dạng chưa cao với nhiều danh thiếp, còn phù thuộc nhiều vào ánh sáng và góc chụp cũng như chất lượng ảnh đầu vào.
– Thời gian thực hiện quá trình nhận dạng tương đối lớn.
3. Hướng phát triển của luận văn.
Trong thời gian tới, hệ thống cần được nâng cấp để nâng cao độ chính xác trong quá trình rút trích thông tin và giảm thời gian trong quá trình thực hiện nhận dạng và rút trích.
E:\DỮ LIỆU COP CỦA CHỊ YẾN\LUAN VAN DUY TAN\LUAN VAN DUY TAN\NGUYEN PHI PALE


